A notícia de hoje mostra que a qualidade do código com IA mudou de fase, e isso importa porque a vantagem deixou de ser apenas gerar mais rápido e passou a ser bloquear, cobrar, auditar e revisar antes que um erro entre no produto.
Em português simples: a IA já ajuda a escrever código, revisar pull request, corrigir bug, mexer em arquivo e sugerir mudança. O problema novo é que, quando isso vira rotina, alguém precisa decidir o que passa no teste, quem paga pela revisão automática, qual workflow pode usar segredo e qual código de fora nunca deve rodar com privilégio.
Esse recorte não repete os últimos posts. Não é outro texto sobre contrato de fornecedor, rastro do trabalho da IA, licença de conteúdo criativo, erro no mundo real ou permissão de conectores. O foco de hoje é mais estreito: a IA que programa precisa entrar no mesmo portão de qualidade do software que ela ajuda a criar.
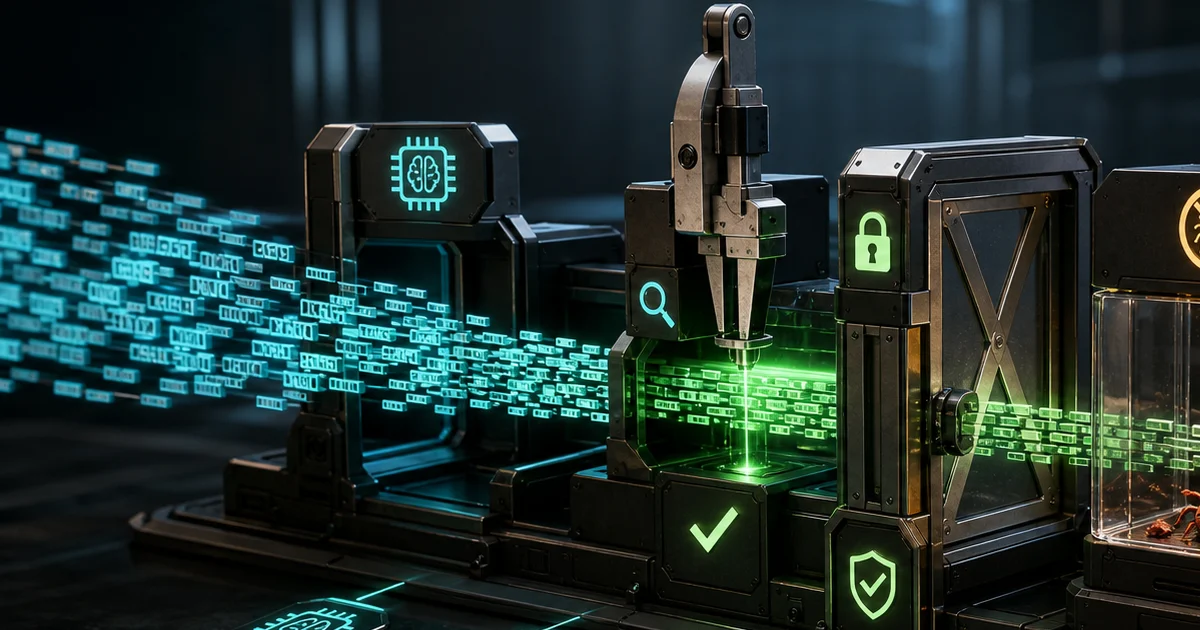 Capa editorial mostrando código gerado por IA passando por testes, portão de segurança e contenção de bugs antes do deploy
TL;DR da IA de hoje
- GitHub Code Quality virou produto pago em 20 de julho: qualidade, cobertura, dashboards, regras de bloqueio e recursos com IA agora entram em orçamento, não só em boa prática.
- GitHub Actions apertou um padrão perigoso de CI:
actions/checkoutpassou a recusar checkouts comuns de pull requests não confiáveis em fluxos privilegiados. - Kimi K3 mostrou a pressão do código gerado por modelo forte: o modelo viralizou, subiu em ranking de frontend coding e a própria demanda forçou pausa de novas assinaturas.
- Hugging Face lembrou que dado também executa risco: um incidente oficial envolveu pipeline de processamento de datasets, execução de código e credenciais internas.
- A decisão prática: se IA toca código, crie um portão mínimo antes do deploy: teste, qualidade, segredo, custo, revisão humana e caminho de rollback.
Notícias selecionadas
1. GitHub transformou qualidade de código em conta e portão
O GitHub havia anunciado que, em 20 de julho de 2026, o GitHub Code Quality sairia do preview público e viraria produto geralmente disponível. A mudança importa porque junta duas coisas que antes muita empresa tratava separadas: qualidade de software e cobrança por trabalho automatizado.
O produto passa a ter preço base de US$ 10 por committer ativo por mês nos repositórios habilitados. Recursos com IA, como Copilot code review, detecção assistida por IA e Copilot Autofix, entram em cobrança por uso. A análise determinística com CodeQL consome minutos de GitHub Actions.
Para leigo: antes, parecia só "vamos ligar mais uma ferramenta para revisar código". Agora a pergunta fica mais concreta: em qual repositório vale pagar para bloquear erro antes do merge?
Por que isso importa: quando IA revisa código, corrige alerta e sugere mudança, qualidade deixa de ser uma opinião no fim do projeto. Vira uma regra de passagem, com custo e dono.
Isso muda a decisão de pequenos times também. Uma PME não precisa ligar tudo em todos os repositórios. Mas precisa separar:
- projeto crítico que mexe com pagamento, cliente, login ou dados;
- projeto interno simples;
- experimento que ainda não tem usuário;
- automação que roda com segredo;
- landing page que só publica conteúdo.
O erro comum é tratar tudo igual. O portão de qualidade deve ser mais forte onde o erro custa mais.
2. O CI passou a proteger melhor contra código não confiável
O GitHub também atualizou a data de aplicação de uma mudança importante no actions/checkout: a proteção para padrões perigosos em pull_request_target foi movida para segunda-feira, 20 de julho de 2026. O contexto está no changelog sobre defaults mais seguros para GitHub Actions checkout.
O problema é técnico, mas a explicação é simples.
Alguns workflows de CI rodam com permissões altas. Eles podem acessar GITHUB_TOKEN, cache, secrets e recursos do repositório principal. Se esse workflow baixa e executa código de um pull request de fork sem cuidado, um atacante pode usar o próprio PR para rodar código com privilégio.
Para leigo: é como deixar um desconhecido entregar uma peça para sua oficina e, antes de conferir, plugar essa peça na tomada principal da empresa.
Por que isso importa: quanto mais IA cria pull request, corrige bug e automatiza manutenção, mais perigoso fica deixar workflow privilegiado rodar código que ainda não foi confiado.
Isso não é um detalhe só para grandes empresas. Muita automação pequena tem:
- token de deploy;
- chave de API;
- acesso a bucket;
- webhook de produção;
- token de GitHub;
- variável de ambiente sensível;
- permissão para publicar site.
Se a IA abre PR, se um bot atualiza dependência ou se um freelancer manda mudança por fork, o workflow precisa tratar aquele código como não confiável até passar pelo portão certo.
3. Kimi K3 mostrou que gerar código melhor aumenta a pressão no portão
A Associated Press publicou em 20 de julho que o Kimi K3 pausou novas assinaturas depois de a demanda superar a capacidade. O modelo da Moonshot chamou atenção por ser um modelo aberto de 2,8 trilhões de parâmetros, com forte desempenho em tarefas de frontend coding.
A própria documentação da Kimi API apresenta o K3 como modelo para long-horizon coding, conhecimento, raciocínio, visão e contexto de 1 milhão de tokens, com pesos completos prometidos até 27 de julho de 2026.
Esse item poderia virar mais um texto sobre ranking de modelo. Não é esse o ponto.
O ponto para quem constrói é outro: quando modelos melhores escrevem mais código, mexem em interfaces, leem screenshots e sustentam tarefas longas, o gargalo muda.
Não basta perguntar:
- ele gera a tela bonita?
- ele passa no benchmark?
- ele parece melhor que o concorrente?
Pergunte:
- o código compila?
- o fluxo quebra no mobile?
- o formulário manda dado certo?
- a validação protege usuário?
- o custo da tarefa valeu?
- existe fallback se o serviço ficar sem capacidade?
- um humano revisou a parte que mexe em dinheiro, conta ou dado?
Por que isso importa: quanto mais convincente fica o código gerado por IA, maior é o risco de aceitar velocidade como se fosse qualidade.
Esse ponto conversa com o post antigo sobre a IA deixar de ser um modelo só, mas o recorte de hoje é diferente. Lá, a pergunta era arquitetura: qual modelo usar para cada tarefa. Hoje, a pergunta é qualidade: qual saída de IA pode entrar no produto sem quebrar nada importante?
4. Hugging Face mostrou que dataset também entra na cadeia de risco
A Hugging Face publicou um relato oficial de incidente de segurança em julho. O ponto mais importante para builders é que a invasão começou em uma área muito típica de plataforma de IA: o pipeline de processamento de dados.
Segundo a empresa, um dataset malicioso abusou de caminhos de execução de código no processamento de datasets. A partir dali, houve escalada para acesso em nó, coleta de credenciais de nuvem e cluster, e movimento lateral em ambientes internos.
Para leigo: não é só o código do app que pode ser perigoso. Em IA, o "dado" às vezes vem com carregador, template, configuração, script, notebook, modelo, ferramenta e pipeline. Parte disso pode executar coisa de verdade.
Por que isso importa: quando IA entra no desenvolvimento, a cadeia de software cresce. Dataset, modelo, loader, action, prompt, plugin e workflow também precisam de revisão.
Esse alerta ajuda a fechar o padrão do dia. Não adianta colocar IA para acelerar entrega se o time roda qualquer asset externo no ambiente errado.
Para produto, marketing ou automação, isso vira regra prática:
- não rode dataset desconhecido com credencial real;
- não teste modelo ou notebook externo no ambiente de produção;
- não exponha
.envpara ferramenta de geração; - não dê permissão de escrita onde leitura bastaria;
- não aceite PR automático sem teste;
- não confunda "veio de comunidade" com "é seguro".
IA aumenta a produtividade, mas também aumenta a quantidade de coisas que passam pela esteira. A esteira precisa ficar mais cuidadosa, não mais frouxa.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que programar com IA saiu da pergunta "ela consegue gerar?" e entrou na pergunta "isso pode passar?".
GitHub Code Quality virou um produto com qualidade, cobertura, score, APIs, regra de bloqueio e cobrança por recurso com IA. O actions/checkout passou a bloquear um padrão perigoso de workflow privilegiado. Kimi K3 mostrou que modelos fortes de código podem ganhar demanda rápido demais para a infraestrutura acompanhar. Hugging Face mostrou que a cadeia de dados da IA também pode virar porta de entrada para ataque.
O fio comum é simples:
- IA escreve mais código;
- IA revisa mais código;
- IA corrige mais alertas;
- IA usa mais ferramentas;
- IA consome mais CI;
- IA puxa mais dado externo;
- IA cria mais mudanças que parecem prontas;
- software ruim continua quebrando do mesmo jeito.
Essa leitura corta uma ilusão comum: achar que o problema de programar com IA é só escolher a ferramenta mais esperta.
Não é.
Ferramenta esperta aumenta a produção. Produto sério precisa aumentar o filtro.
Quem acompanha /noticias vai continuar vendo modelos de coding, agentes, copilotos e automações novas. O filtro de hoje é outro: se uma IA abrir um pull request agora, seu processo sabe decidir se ele pode entrar?
O que isso muda pra quem constrói
1. Crie um portão mínimo para código feito com IA. Nenhuma mudança que mexe em cliente, pagamento, login, dado ou deploy deveria entrar sem build, teste, revisão e rollback.
2. Separe qualidade por risco. Repositório crítico merece regra mais dura. Experimento pode ter portão leve. O erro é usar o mesmo nível para tudo.
3. Trate CI como parte da segurança. Workflow que roda com segredo não deve executar código não confiável sem desenho explícito. Se precisar abrir exceção, ela precisa aparecer em revisão.
4. Calcule o custo da revisão automática. Se a ferramenta cobra por committer, PR, token, análise ou autofix, escolha onde ela gera mais valor. Revisar tudo com IA pode ser desperdício; revisar nada pode ser risco.
5. Use IA para procurar erro, não só para criar mudança. Peça teste, cenário ruim, caso mobile, validação de formulário, revisão de permissão e explicação do risco.
6. Trate dataset e modelo externo como dependência. Baixou, executou ou carregou no pipeline? Então merece sandbox, permissão mínima e origem registrada.
Para builders, founders, marketers, criadores, PMEs e profissionais que usam IA para produto, automação e negócio, a decisão prática é esta: antes de pedir para a IA escrever mais código, desenhe o portão que decide o que entra em produção.
E o Brasil nessa história?
No Brasil, essa virada vai aparecer de um jeito muito comum: site, checkout, automação, planilha, chatbot, integração de WhatsApp, script de anúncio, rotina de e-mail, landing page e sistema interno feitos com ajuda de IA.
Isso é bom. Uma PME pode construir mais rápido sem contratar um time enorme.
Mas o risco também é simples:
- formulário que salva dado errado;
- checkout que perde parâmetro;
- página que quebra no celular;
- webhook sem validação;
- automação que manda e-mail duplicado;
- token exposto no GitHub;
- dependência copiada sem entender;
- deploy feito porque a IA disse que "parece certo".
O caminho prático não é parar de usar IA. É criar uma esteira pequena:
- IA escreve ou altera.
- Humano lê a parte sensível.
- Teste roda.
- Build roda.
- Workflow não usa segredo com código não confiável.
- Deploy tem rollback.
- Erro encontrado vira regra para a próxima revisão.
Isso vale até para quem não é programador profissional. Se você vende site, automação ou funil com IA, precisa entregar mais do que velocidade. Precisa entregar confiança operacional.
Se você quer transformar esse tipo de leitura em produto, automação, marketing ou rotina comercial com método, o caminho mais direto é entrar no /pro. E para acompanhar as próximas viradas práticas do mercado, veja a curadoria em /noticias.
A pergunta final de hoje é:
qual mudança feita com IA entraria no seu produto hoje sem passar por teste nenhum?
Comece por essa. A próxima vantagem não é gerar mais código. É deixar menos erro passar.