A notícia de hoje mostra que a arquitetura de IA mudou de fase, e isso importa porque produto útil agora mistura modelo local, modelo especializado e fluxo de simulação em vez de depender de um modelo gigante para tudo.
Em português simples: a IA está ficando menos parecida com "um cérebro mágico na nuvem" e mais parecida com uma oficina. Tem ferramenta pequena para tarefa rápida, ferramenta local para dado sensível, modelo maior para problema difícil e simulação para testar antes de soltar no mundo real.
Esse recorte não repete os últimos posts. Não é outro texto sobre emprego, custo externo, governança interna, dados conectados ou prompt virando app. O foco de hoje é a decisão de arquitetura: qual parte do trabalho deve rodar perto do usuário, qual deve usar modelo especializado e qual ainda precisa de modelo de fronteira.
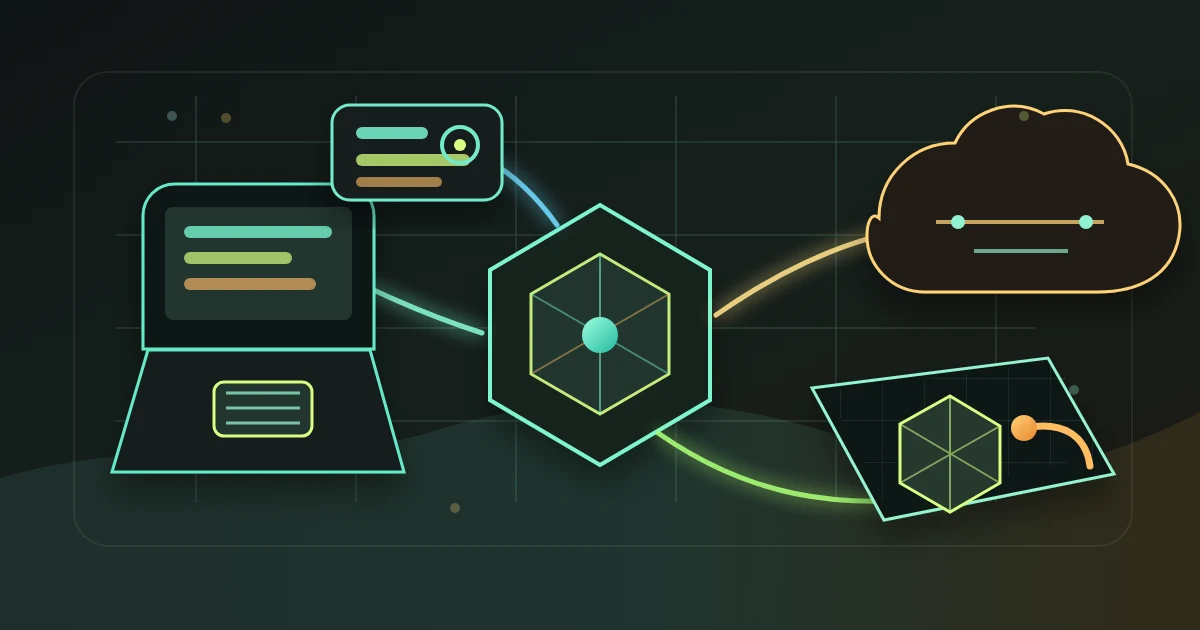 Capa editorial mostrando uma bancada de produto com laptop, chip local, roteador de modelos, nuvem e simulação 3D conectados por IA
TL;DR do dia
- Google levou Gemma 4 12B para laptops comuns: a IA local começa a fazer análise, voz, código e ferramentas sem mandar tudo para a nuvem.
- GitHub levou BYOK e modelos por tarefa ao VS Code: times podem escolher modelos para tarefas auxiliares, ambientes isolados e esforço de raciocínio.
- NVIDIA mostrou skills para IA física: em robôs, veículos e visão computacional, o valor está no fluxo de simulação, dado sintético, treino e avaliação.
- A decisão prática: pare de perguntar apenas "qual é o melhor modelo?". Pergunte qual tarefa precisa de modelo local, modelo pequeno, modelo grande ou simulação.
1. Google mostra que IA local virou opção real
O Google publicou em 3 de junho o guia Bringing Gemma 4 12B to your Laptop. A proposta é colocar capacidades agentivas e multimodais da Gemma 4 12B diretamente em laptops do dia a dia, usando a pilha Google AI Edge.
O anúncio junta três peças úteis.
A primeira é o Google AI Edge Gallery no macOS, com exemplos de análise de dados e geração de scripts rodando no dispositivo. A segunda é o Google AI Edge Eloquent, um app de ditado e edição por voz 100% on-device. A terceira é o LiteRT-LM com comando serve, que permite criar um endpoint local compatível com o padrão usado por muitas ferramentas de IA.
Para leigo: isso significa que algumas tarefas de IA podem acontecer dentro do seu próprio computador, sem depender de internet, token por token, fila de API ou envio de arquivo para um servidor distante.
Por que isso importa: IA local não substitui todo modelo grande. Mas muda a conta para tarefas repetidas, privadas, simples, sensíveis a latência ou baratas demais para justificar nuvem.
Exemplos práticos para builder, PME ou profissional:
- ditar e reescrever texto sem enviar áudio para fora;
- resumir notas internas simples no próprio computador;
- rodar triagens leves antes de chamar um modelo caro;
- transformar uma planilha pequena em análise local;
- testar protótipo de ferramenta com dado sensível;
- manter uma automação funcionando mesmo com conexão ruim.
O ponto não é virar purista de IA local. É desenhar melhor o caminho. Se a tarefa é simples, recorrente e privada, talvez ela não precise atravessar o mundo até um data center.
2. GitHub mostra que cada tarefa pode ter seu modelo
O GitHub publicou em 3 de junho o changelog GitHub Copilot in Visual Studio Code, May releases. No meio de muitas novidades de agentes, aparece um sinal importante para arquitetura de IA: o VS Code expandiu suporte a bring-your-own-key, ou BYOK, para ambientes air-gapped, adicionou endpoint customizado, seletor de modelos por provedor, visibilidade de tokens e controles de esforço de raciocínio.
O detalhe mais interessante é a parte de modelos utilitários configuráveis. O produto permite escolher quais modelos cuidam de títulos, resumos, sugestões de renomeação, mensagens de commit e detecção de intenção.
Para leigo: dentro de uma ferramenta de trabalho, nem toda IA precisa ser a mais poderosa. Uma IA pode entender a intenção. Outra pode resumir. Outra pode escrever uma mensagem de commit. Outra pode fazer raciocínio pesado quando o risco justificar.
Isso parece detalhe de desenvolvedor, mas é uma mudança de produto.
Em vez de perguntar "qual modelo usamos?", a pergunta vira:
- qual modelo cuida da tarefa barata;
- qual modelo cuida da tarefa crítica;
- qual modelo pode rodar em ambiente isolado;
- qual modelo precisa mostrar uso real de tokens;
- qual modelo merece mais esforço de raciocínio;
- qual tarefa pode usar chave própria do cliente.
Por que isso importa: quando a ferramenta deixa o time escolher modelo por tarefa, IA vira arquitetura configurável, não só assinatura de chatbot.
Para builders, esse recado é direto. Se seu produto usa IA para atendimento, CRM, proposta, conteúdo, revisão ou análise, você não precisa mandar todas as etapas para o mesmo modelo.
Você pode desenhar uma combinação:
- modelo pequeno para triagem;
- modelo local para dado sensível;
- modelo barato para tarefa frequente;
- modelo grande para raciocínio difícil;
- chave própria para cliente enterprise;
- regra de roteamento para decidir quem faz o quê.
Esse ponto conversa com o post sobre open source contra lock-in de IA, mas o recorte de hoje é diferente. Não é "use open source para fugir de fornecedor". É "use modelos diferentes porque produto real tem tarefas diferentes".
3. NVIDIA mostra que IA física precisa de fluxo, não só modelo
A NVIDIA publicou em 3 de junho uma atualização sobre physical AI agent skills para veículos autônomos, robótica e visão computacional. A empresa apresentou ferramentas ligadas ao Cosmos 3, Isaac Sim, Isaac Lab, Omniverse e Metropolis para acelerar geração de dados, simulação, treino de políticas e avaliação.
Essa notícia parece distante de uma PME brasileira, mas a ideia central é simples e útil: quando a IA sai do texto e começa a enxergar, dirigir, controlar máquina, detectar defeito ou orientar robô, o problema não é só ter um modelo mais forte.
O problema é criar um ciclo completo:
- reconstruir uma cena real;
- gerar casos raros;
- simular variações;
- treinar comportamento;
- avaliar falhas;
- repetir o teste;
- comparar versões antes de colocar em produção.
Em veículos autônomos, isso aparece no "rabo longo" de situações difíceis: iluminação estranha, geometria incomum, interação rara no trânsito. Em inspeção visual, aparece em defeitos raros que quase nunca entram na base de treino. Em robótica, aparece em ambiente, física, manipulação e transferência da simulação para o mundo real.
Por que isso importa: quando a IA mexe no mundo físico ou em processo crítico, o produto não pode depender de demo bonita. Ele precisa de ambiente de teste, caso raro e avaliação repetível.
Para quem constrói fora da robótica, a tradução é direta. Atendimento, vendas, cobrança, jurídico, estoque, conteúdo e operação também têm "casos raros" que quebram automação.
Exemplos:
- cliente irritado com pedido atrasado;
- lead importante pedindo desconto fora da regra;
- contrato com cláusula incomum;
- boleto vencido com renegociação;
- produto fora de estoque durante campanha;
- comentário sensível em comunidade;
- dado duplicado no CRM;
- pedido em português informal ou cheio de erro.
Se o caso raro custa caro, ele precisa entrar no teste. Essa é a lição da IA física para qualquer produto com IA.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que o modelo único perdeu espaço para a arquitetura em camadas.
Google está mostrando que parte da IA pode rodar no laptop, perto do usuário e do dado. GitHub está mostrando que uma ferramenta de trabalho pode escolher modelos diferentes para tarefas diferentes. NVIDIA está mostrando que, quando a IA toca o mundo físico, o valor aparece no fluxo inteiro: simulação, dado sintético, treino, avaliação e repetição.
O fio comum é:
- nem toda tarefa precisa do maior modelo;
- nem todo dado deve sair do dispositivo;
- nem toda resposta precisa ir para a nuvem;
- nem todo agente deve fazer tudo sozinho;
- nem todo teste pode ser feito só na produção;
- nem todo custo aparece no preço do token.
Essa fase é menos chamativa que "novo modelo bateu benchmark". Mas é mais importante para produto. Um sistema de IA bom começa a parecer menos com uma caixa preta e mais com uma cadeia de decisões.
O que isso muda pra quem constrói
1. Faça um mapa simples de tarefas. Liste as tarefas de IA do seu produto ou operação: resumo, triagem, resposta, busca, análise, geração, revisão, decisão e ação. Depois marque quais são simples, repetidas, sensíveis ou críticas.
2. Separe IA local de IA em nuvem. Dado sensível, áudio, rascunho interno, protótipo e pré-processamento podem ser bons candidatos para rodar localmente. Raciocínio complexo, análise profunda e tarefas com muito contexto ainda podem justificar modelo grande.
3. Crie uma regra de roteamento. Antes de chamar o modelo caro, pergunte: uma etapa menor consegue classificar, resumir, limpar ou decidir o próximo passo? Isso reduz custo e melhora previsibilidade.
4. Use modelo especializado para tarefa frequente. Se uma etapa aparece mil vezes por dia, ela não deveria depender sempre do modelo mais caro. Procure uma solução rápida, testável e ajustada ao trabalho.
5. Teste casos raros cedo. Se a automação pode afetar cliente, dinheiro, contrato, estoque, saúde, segurança ou reputação, crie exemplos difíceis antes de escalar. Não espere o erro real virar o primeiro teste.
6. Meça o sistema, não só a resposta. Latência, custo, taxa de erro, privacidade, revisão humana e fallback importam tanto quanto "qual modelo respondeu melhor no prompt".
Esse é um complemento natural para quem acompanha /noticias: modelos importam, mas a decisão útil está em como eles entram no produto. O guia sobre MCP também ajuda nesse ponto, porque conector e contexto viram parte da arquitetura.
E o Brasil nessa história?
Para o Brasil, essa virada é mais prática do que parece.
Muita empresa brasileira usa IA em uma operação cheia de restrição: internet instável, orçamento em real, cobrança em dólar, dados sensíveis, LGPD, WhatsApp, planilha, CRM simples, equipe pequena e pouco tempo para engenharia.
Nesse cenário, "jogar tudo no modelo gigante" pode funcionar na demo e ficar ruim na operação. Fica caro, lento, frágil ou arriscado.
A oportunidade para builders, consultores, agências e PMEs é vender e construir uma arquitetura simples:
- IA local para rascunho, áudio, limpeza e tarefas privadas;
- modelo barato para volume;
- modelo grande para decisões difíceis;
- simulação ou planilha de testes para casos raros;
- revisão humana onde o impacto é alto;
- fallback manual quando a automação falha.
Não precisa começar sofisticado. Uma pequena empresa pode começar com uma pergunta:
quais tarefas de IA são simples demais para modelo caro, sensíveis demais para nuvem ou críticas demais para não serem testadas?
Esse é o tipo de decisão que separa uso curioso de uso profissional.
A pergunta para hoje
Escolha uma automação, feature ou rotina com IA e responda:
Que parte disso deveria rodar localmente, que parte deveria usar um modelo pequeno e que parte realmente merece um modelo gigante?
Se você não sabe responder, o próximo passo não é trocar de ferramenta. É desenhar o caminho da tarefa.
No Pro, a curadoria diária segue filtrando IA por decisão prática: produto, automação, marketing, stack, custo, arquitetura e negócio.