A notícia de hoje mostra que a interface da IA mudou de fase, e isso importa porque a IA deixou de morar só na caixa de texto e começou a aparecer dentro do lugar onde o trabalho realmente acontece: no pull request, no arquivo, no celular, no navegador e na defesa de sistemas.
Em português simples: durante muito tempo, usar IA parecia abrir um chat e pedir uma resposta. Agora a pergunta ficou mais prática. Em que ponto do fluxo a IA deve aparecer? Ela só sugere? Ela monta o arquivo? Ela aprova? Ela roda no aparelho? Ela fica perto do dado? Ela defende o sistema enquanto o ataque também fica automático?
Esse recorte não repete os últimos posts. Não é outro texto sobre método, cobrança por resultado, recibo de origem, porta de acesso ou adoção de última milha. O foco de hoje é interface: o que muda quando a IA deixa de ser uma conversa separada e passa a ocupar a superfície exata da decisão.
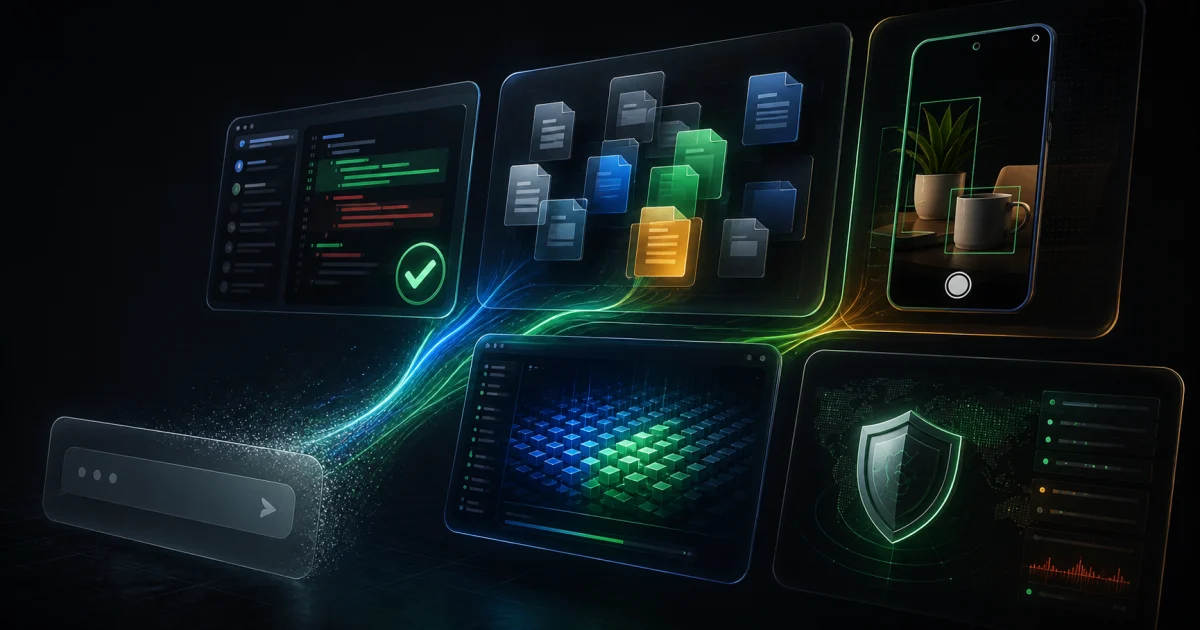 Capa editorial mostrando a caixa de texto da IA ficando secundária enquanto interfaces de código, arquivos, celular, navegador e segurança assumem o centro
TL;DR: o chat virou só uma entrada
- O GitHub colocou a IA mais perto da aprovação: o Copilot Code Review agora pode dizer quando um pull request está pronto, e administradores podem permitir que ele aprove.
- O Android levou Gemini para objetos e acessibilidade: a IA começa a lembrar onde você colocou coisas e a descrever o mundo pela câmera, não só responder texto.
- A Hugging Face publicou kernels WebGPU para IA local: parte da pilha de IA pode rodar no navegador, com testes e benchmarks por dispositivo.
- A OpenAI segurou Astra para reforçar salvaguardas: quando a capacidade passa de certo limite, liberar o modelo vira decisão de acesso, monitoramento e ambiente.
- A Anthropic lançou Fable 5.1 com foco em trabalho longo: a disputa não é só inteligência; é custo por tarefa, cache, privacidade e menos bloqueio falso.
- A NVIDIA e a CrowdStrike levaram agentes para cyberdefesa: se o ataque ficou automatizado, a defesa também vira sistema contínuo, não chat de consulta.
- A decisão prática: pare de desenhar IA como "uma janela de conversa" e comece pelo ponto de trabalho: artefato, aprovação, aparelho, dado, risco e humano responsável.
Notícias selecionadas
1. GitHub deu à IA um lugar perto do botão de aprovar
O GitHub anunciou que o Copilot Code Review agora pode avaliar se um pull request está pronto para aprovação. A função aparece em preview público para planos Copilot Pro, Pro+, Max, Business e Enterprise.
O detalhe importante: a aprovação automática vem desligada por padrão. Administradores podem liberar a capacidade no nível de empresa, organização ou repositório. Mesmo quando a IA aprova, isso não elimina a responsabilidade do time que escolheu deixar aquela aprovação contar.
Para leigo: antes a IA era como alguém dando pitaco no código. Agora ela chega perto do carimbo que diz "pode seguir".
Por que isso importa: quando a IA entra no ponto de aprovação, ela deixa de ser só assistente e passa a fazer parte do controle de qualidade.
Para quem constrói produto, isso muda a arquitetura do fluxo. Uma coisa é a IA comentar. Outra é a IA bloquear, liberar, aprovar ou assinar uma etapa. O produto precisa deixar claro:
- quando a IA só sugere;
- quando ela recomenda aprovação;
- quando a aprovação vale de verdade;
- quem configurou esse poder;
- que tipo de mudança continua exigindo humano;
- qual log prova a decisão depois.
Essa é a diferença entre "usar IA para revisar" e "colocar IA dentro do mecanismo de revisão".
2. Google levou Gemini para memória física e acessibilidade
O Google publicou o September Android Drop com novas funções que mostram uma IA menos presa ao chat.
Duas chamam atenção. Em aparelhos compatíveis, o usuário poderá pedir ao Gemini para lembrar onde guardou objetos no Find Hub, como chaves, documentos ou passaporte. Em outra frente, o Guided Vision no Gemini Live usa a câmera para descrever o que está ao redor e orientar pessoas cegas ou com baixa visão a enquadrar melhor um objeto.
Para leigo: a IA sai da pergunta digitada e começa a operar como recurso do aparelho. Ela lembra uma coisa física. Ela ouve. Ela vê. Ela ajuda a pessoa a apontar a câmera.
Por que isso importa: quando a IA entra no dispositivo, o produto precisa pensar em contexto, privacidade, acessibilidade e momento de uso.
Isso é maior do que um recurso de Android. Mostra uma direção de interface: a melhor IA nem sempre parece um chat. Às vezes ela parece uma memória. Às vezes parece uma câmera que explica. Às vezes parece um atalho de acessibilidade. Às vezes aparece só no instante em que a pessoa precisa decidir.
Para builders e PMEs, a pergunta prática é: o seu produto de IA deveria ficar em uma conversa separada ou dentro do canal onde o usuário já está tentando resolver o problema?
3. Hugging Face empurrou IA local para dentro do navegador
A Hugging Face lançou o @huggingface/kernels, uma biblioteca mínima para carregar e rodar kernels WebGPU publicados no Hub. A primeira coleção vem com 207 kernels e inclui contratos, testes de correção, benchmarks e instruções de uso.
O anúncio também apresentou o Fleet, uma suíte de benchmark no navegador. A ideia é que a comunidade teste desempenho e correção em uma variedade de aparelhos que um laboratório central dificilmente conseguiria cobrir sozinho.
Para leigo: kernel é uma peça muito baixa da máquina de IA, responsável por operações matemáticas rápidas. Quando isso fica melhor no navegador, parte da IA pode acontecer no próprio dispositivo, sem depender sempre de servidor pesado.
Por que isso importa: se a IA roda perto do usuário, mudam custo, latência, privacidade e desenho de produto.
Essa notícia conversa com o post antigo sobre IA saindo do chat e entrando na tela do trabalho, mas o recorte de hoje é outro. Lá, o foco era a tela como ambiente de trabalho. Hoje, o ponto é mais baixo: a própria infraestrutura da interface começa a permitir IA local, testável e distribuída.
Para quem faz SaaS, extensão, ferramenta interna, produto educacional ou app de produtividade, isso abre uma pergunta concreta: que parte da IA precisa ir para a nuvem e que parte poderia rodar no navegador para responder mais rápido, gastar menos e expor menos dado?
4. OpenAI mostrou que alguns modelos não podem ser liberados como chat comum
A OpenAI publicou uma atualização sobre o caminho para o Astra, dizendo que o modelo atingiu o patamar crítico de capacidade em cibersegurança dentro do seu Preparedness Framework. Segundo a empresa, com ferramentas e acesso certos, o modelo consegue encontrar falhas desconhecidas e desenvolver formas de exploração em sistemas bem protegidos, sem uma pessoa guiando cada etapa.
A empresa afirma que atrasou partes do desenvolvimento e da liberação do Astra para reforçar proteções contra mau uso em cyber e ações não autorizadas. O acesso às capacidades mais avançadas de cibersegurança deve começar mais limitado, com grupos de testadores e expansão voltada a uso defensivo.
Para leigo: um modelo muito capaz não é apenas "chat melhor". É uma ferramenta que pode fazer coisas perigosas se cair no ambiente errado.
Por que isso importa: quanto mais a IA se aproxima de ação real, mais a interface precisa carregar limite, monitoramento e nível de acesso.
Esse ponto ajuda a entender por que o futuro da IA não será um único botão mágico. O mesmo modelo pode ser útil para revisar código, achar vulnerabilidade, treinar time, auditar sistema ou atacar alvo. O que muda não é só a resposta. Muda o ambiente, a credencial, a política, o monitoramento e o usuário autorizado.
Para produto, a lição é clara: recurso poderoso precisa de superfície poderosa. Não basta esconder risco em termo de uso. O produto precisa guiar o usuário para o uso certo e bloquear combinações perigosas.
5. Anthropic lançou Fable 5.1 como pacote de trabalho, não só como modelo
A Anthropic anunciou Claude Fable 5.1 e Claude Mythos 5.1. O Fable 5.1 está disponível de forma geral; o Mythos 5.1 fica restrito a programas de acesso confiável para áreas como cibersegurança e ciências da vida.
O sinal editorial não está apenas nos benchmarks. A Anthropic embalou o lançamento junto com mudanças de custo, cache, privacidade e salvaguardas. A empresa diz que o Fable 5.1 fica cerca de 25% mais barato em cargas típicas por causa de redução em cache reads, com economia maior em trabalhos altamente agentic. Também conectou o modelo ao Enterprise Frontier Safeguards, solução em que dados e logs ficam na infraestrutura controlada pelo cliente.
Para leigo: não é só "o Claude ficou mais inteligente". É "o Claude precisa trabalhar por mais tempo, em tarefas mais caras, com menos atrito e mais controle sobre dado".
Por que isso importa: modelo forte, sozinho, ainda não vira produto. Ele precisa caber no custo da tarefa e no ambiente em que a empresa aceita operar.
Essa notícia reforça a tese do dia. Quando a IA vira parte do trabalho, ela precisa aparecer no lugar certo: no editor, no documento, no agente, no ambiente de nuvem, no repositório, na auditoria e na rotina do time. A caixa de texto continua existindo, mas deixa de ser a arquitetura principal.
6. NVIDIA e CrowdStrike trataram cyberdefesa como sistema contínuo
A NVIDIA anunciou com a CrowdStrike o SafeMind, sistema de cibersegurança agentic criado com modelos NVIDIA Nemotron e dados de ameaça da CrowdStrike. A proposta é usar agentes em um ciclo contínuo em que ataque simulado e defesa se desafiam para endurecer o ambiente do cliente.
Também foram anunciados recursos ligados ao Falcon IQ e ao Guardian AI. O ponto comum é que segurança com IA começa a parecer menos uma consulta pontual e mais uma operação persistente.
Para leigo: se o atacante usa IA para automatizar tentativa, variação e exploração, a defesa não pode depender só de alguém perguntando algo para um chatbot depois do alarme.
Por que isso importa: em áreas críticas, a IA precisa viver dentro do sistema que observa e reage, não fora dele como ferramenta de apoio ocasional.
Isso não significa entregar tudo para agentes autônomos. Significa que o desenho do produto muda. Cyberdefesa, revisão de código, atendimento, finanças e operações sensíveis precisam de IA acoplada ao fluxo, com telemetria, limite e escala.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que o chat virou apenas uma das entradas possíveis.
GitHub mostra IA no ponto de aprovação de código. Google mostra IA como função do aparelho e recurso de acessibilidade. Hugging Face mostra que IA pode rodar em camadas baixas do navegador. OpenAI mostra que modelo poderoso exige ambiente controlado antes de chegar ao público. Anthropic mostra que modelo novo precisa vir com custo, cache, privacidade e salvaguarda. NVIDIA e CrowdStrike mostram IA como parte de uma operação contínua de defesa.
O fio comum é simples:
- a caixa de texto continua útil;
- mas o trabalho real acontece em outro lugar;
- o valor aparece quando a IA entra nesse lugar;
- cada lugar muda a regra da IA;
- aprovar código não é igual a escrever resumo;
- lembrar objeto físico não é igual a responder pergunta;
- rodar no navegador não é igual a rodar na nuvem;
- defender sistema não é igual a explicar segurança;
- modelo forte sem interface correta vira risco, custo ou fricção.
Essa leitura corta uma ilusão comum: achar que produto de IA é sempre "um chat com mais contexto".
Não é.
Produto de IA é decidir onde a inteligência entra. Às vezes é antes do clique. Às vezes é depois do alerta. Às vezes é dentro do arquivo. Às vezes é no dispositivo. Às vezes é no botão de aprovar. Às vezes é longe do usuário, rodando como defesa silenciosa.
Quem acompanha /noticias vai continuar vendo modelos, agentes e lançamentos. O filtro de hoje é outro: qual é o lugar exato onde a IA deveria aparecer para reduzir atrito sem esconder responsabilidade?
O que isso muda pra quem constrói
1. Comece pelo ponto de trabalho, não pelo chat. Pergunte onde a decisão acontece: pull request, planilha, WhatsApp, CRM, câmera, formulário, painel, fila, checkout, e-mail ou documento.
2. Separe sugestão, criação e aprovação. Uma IA que sugere frase tem um risco. Uma IA que gera arquivo final tem outro. Uma IA que aprova, publica, paga ou bloqueia precisa de regra própria.
3. Escolha onde a IA roda. Nuvem é boa para tarefas pesadas. Navegador e dispositivo podem ser melhores para latência, privacidade, custo e experiência imediata. Nem tudo precisa ir para a API central.
4. Desenhe o humano responsável. Se a IA fica perto do botão decisivo, alguém precisa saber quem autorizou, que escopo vale e quando a decisão volta para uma pessoa.
5. Faça a interface mostrar o limite. Produto bom não deixa o usuário adivinhar se a IA pode acessar dado, executar ação ou guardar informação. O limite deve aparecer no fluxo.
6. Teste casos de borda no lugar real. Não teste só no chat limpo. Teste no PR grande, no arquivo bagunçado, no celular com ruído, no navegador fraco, na fila atrasada e no alerta de segurança realista.
Para builders, founders, marketers, criadores, PMEs e profissionais que usam IA para produto, automação e negócio, a decisão prática é esta: escolha uma automação e redesenhe a pergunta de "qual prompt usar?" para "em qual ponto do fluxo a IA deve entrar, com qual poder e com qual limite?".
Essa mudança evita dois erros caros: criar um chatbot que ninguém quer abrir e criar um agente que age perto demais do risco sem controle suficiente.
E o Brasil nessa história?
No Brasil, essa virada é muito prática porque boa parte do trabalho já acontece em interfaces simples e espalhadas.
O vendedor decide no WhatsApp. A agência revisa em documento, pasta e gerenciador de anúncios. A clínica recebe áudio, foto e formulário. A escola lida com celular do aluno. A loja pequena controla estoque em planilha. O consultor monta proposta em PDF. O time dev aprova mudança no GitHub. O financeiro confirma Pix, cobrança e boleto em sistemas diferentes.
Se a IA fica isolada em uma aba de chat, ela ajuda, mas não transforma o fluxo. A pessoa precisa copiar, colar, conferir, voltar, ajustar, pedir de novo e assumir o risco sozinha.
O caminho mais forte para PMEs brasileiras não é vender "mais um chatbot". É colocar IA nos pontos onde o trabalho já acontece:
- resumo de áudio dentro do atendimento;
- sugestão de resposta antes do envio;
- revisão de proposta no próprio documento;
- alerta de cobrança antes da promessa errada;
- checagem de pedido antes do checkout;
- triagem visual com confirmação humana;
- análise de PR no fluxo de deploy;
- IA local quando o dado não deve sair do aparelho;
- painel que mostra o limite da automação antes da ação.
Esse post conversa com o texto sobre IA ter saído do chat e entrado na tela do trabalho. A diferença de hoje é que a interface ficou mais ampla: não é só a tela do trabalho. É o arquivo, o aparelho, o navegador, a aprovação, o ambiente de execução e o sistema de defesa.
Se você quer transformar esse tipo de leitura em produto, automação, marketing ou rotina operacional com método, o caminho mais direto é entrar no /pro. E para acompanhar as próximas viradas práticas sem cair em resumo genérico, veja a curadoria em /noticias.
A pergunta final de hoje é:
onde a sua IA ainda está presa em uma caixa de texto, quando deveria estar dentro do ponto exato da decisão?
Comece por esse ponto. A próxima vantagem não será só conversar melhor com a IA. Será colocar a IA no lugar certo, com poder suficiente para ajudar e limite suficiente para não virar problema.