Wikimedia pede distinção entre treinar IA e reproduzir obras protegidas
A Wikimedia Foundation apresentou aos tribunais uma posição intermediária nos processos de direitos autorais contra OpenAI e Microsoft. Para a entidade, respostas que substituem a leitura das obras originais devem exigir licença.
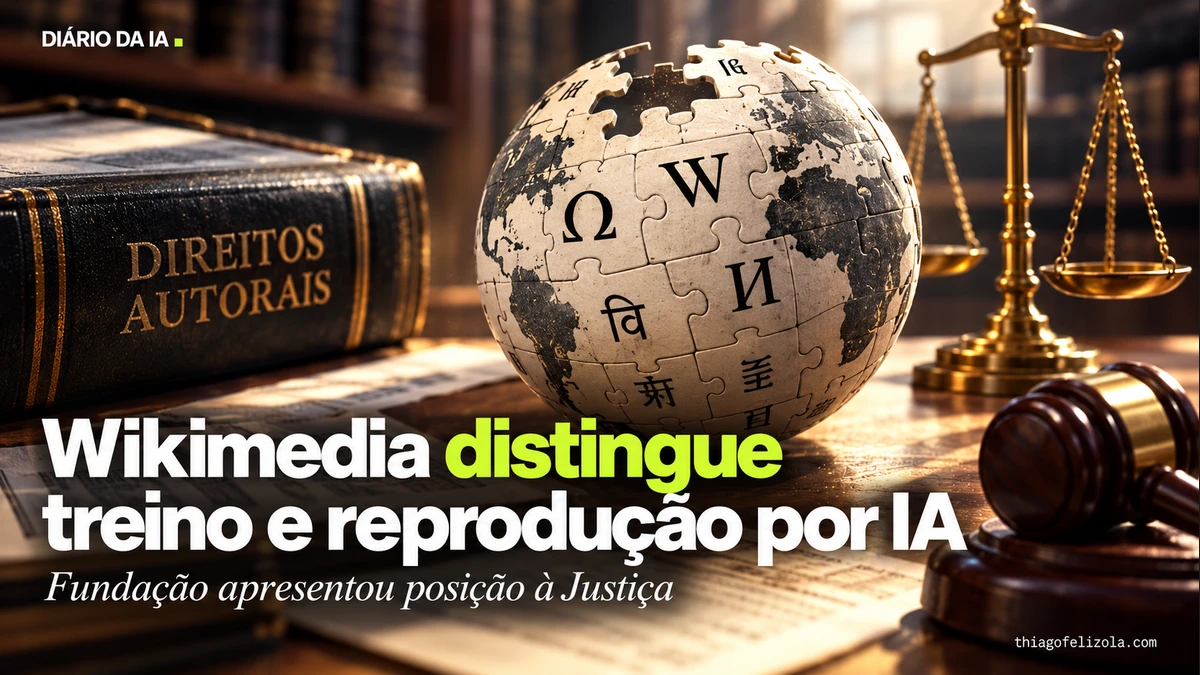
A Wikimedia Foundation apresentou, na sexta-feira, um documento judicial sobre ações de direitos autorais que incluem o processo do The New York Times contra OpenAI e Microsoft. A organização responsável pela Wikipedia não apoia nenhum dos lados e pede que os tribunais diferenciem o treinamento de modelos de IA da reprodução de obras para usuários.
A fundação argumenta que coletar conteúdo de sites não deve ser considerado violação de direitos autorais e que usar obras para pré-treinar modelos sem licença pode ser uso justo quando o sistema produz “algo novo e diferente” das fontes. Já respostas que reproduzem material e substituem a leitura das obras originais deveriam exigir licença. Para conteúdo da Wikipedia, isso incluiria atribuição da fonte e a manutenção da licença Creative Commons nas adaptações.
Segundo a Wikimedia, uma decisão ampla demais em favor dos detentores de direitos poderia restringir usos inovadores; uma vitória abrangente das empresas de IA poderia enfraquecer licenças e fragmentar o fluxo de conhecimento. A entidade também afirma que modelos podem ajudar editores a combater vandalismo, identificar violações de direitos autorais e encontrar artigos que precisam de melhorias. Ao mesmo tempo, diz que esses sistemas desviam visitantes dos sites que fornecem conteúdo.
O que muda para você
A posição da Wikimedia é um argumento apresentado à Justiça, não uma regra em vigor. A disputa interessa a quem publica conteúdo, desenvolve modelos ou usa bases abertas: uma decisão poderá definir quando o treinamento sem licença é permitido e quando respostas que reproduzem obras precisam de autorização. Para quem usa ferramentas de IA, nada muda de imediato.
Minha leitura
A discussão vai além de como os modelos aprendem: trata também do que acontece quando entregam conteúdo que dispensa a visita à fonte. Essa diferença é relevante para quem publica e para quem cria ferramentas de IA, mas ainda está em debate judicial. Eu avaliaria cada caso perguntando se a resposta transforma a informação ou se apenas substitui o acesso à obra original.
 Thiago FelizolaConsultor de IA, curador do Diário da IA