A notícia de hoje mostra que a memória da IA mudou de fase, e isso importa porque a IA útil deixou de responder cada pergunta do zero. Agora ela precisa manter contexto vivo, correto, barato e fácil de revisar.
Em português simples: lembrar é ótimo quando a IA sabe seu projeto, seu cliente, sua restrição e seu jeito de trabalhar. Mas lembrar errado é pior do que esquecer. Um preço antigo, uma preferência que mudou, um briefing vencido ou uma conclusão tirada de uma conversa velha podem virar recomendação ruim com cara de personalização.
Esse recorte não repete os últimos posts. Não é outro texto sobre arquitetura em camadas, prompt virando app, filtro de trabalho, custo externo ou governança de modelos. O foco de hoje é experiência e operação: quando a IA começa a lembrar, quem decide o que entra, o que sai e o que precisa ser esquecido?
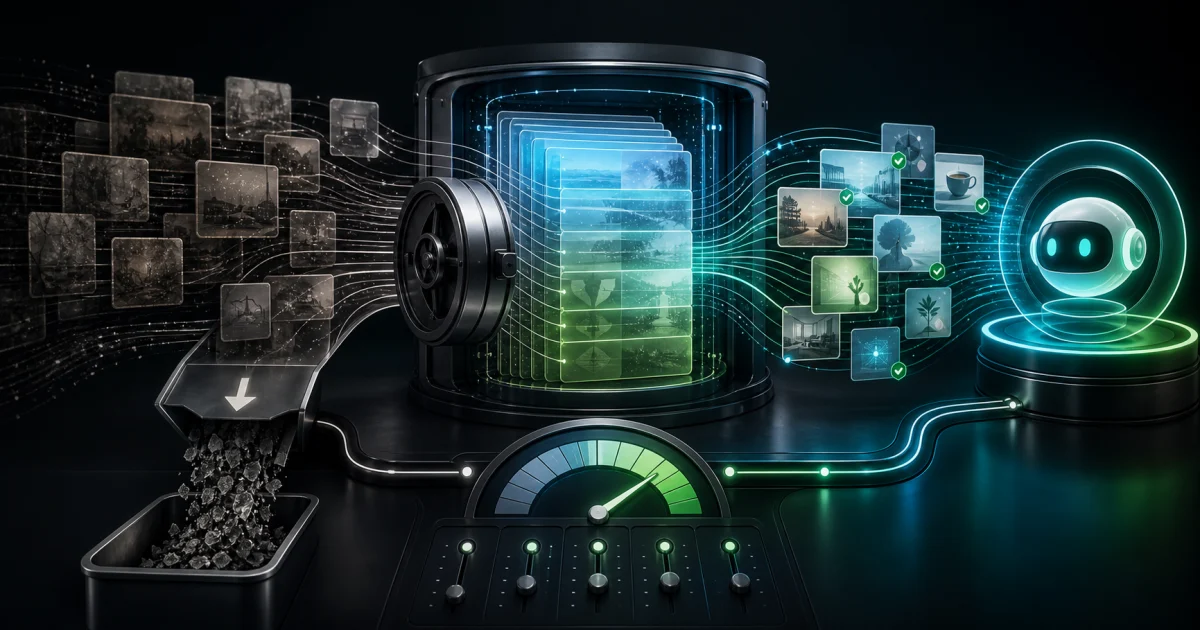 Capa editorial mostrando um cofre de memória de IA, cartões antigos sendo descartados, cartões válidos entrando no assistente e um medidor de contexto
TL;DR do dia
- OpenAI melhorou a memória do ChatGPT: o novo sistema Dreaming sintetiza histórico para dar continuidade, seguir preferências e reduzir informação velha ou errada.
- A pesquisa mostrou que memória ainda é difícil: o benchmark MemoryDocDataSet junta conversas de meses com documentos longos, e o melhor baseline ainda fica longe de resolver bem o problema.
- GitHub aumentou contexto e raciocínio do Copilot: janelas de até 1 milhão de tokens ajudam em trabalhos grandes, mas custam mais créditos e exigem escolha consciente.
- Copilot colocou contexto na interface: anel de uso, resumo de conversa, commits anexados e PRs com contexto automático mostram que contexto virou parte da UX.
- A decisão prática: pare de tratar memória como mágica. Todo produto com IA precisa de regra para lembrar, resumir, corrigir, expirar e esquecer.
1. OpenAI mostra que memória virou produto
A OpenAI publicou em 4 de junho o texto Dreaming: Better memory for a more helpful ChatGPT. O ponto central é que o ChatGPT passa a usar uma arquitetura de memória mais capaz para sintetizar histórico e lidar melhor com três problemas: informação velha, correção e escala.
A empresa explica que a memória ajuda o ChatGPT a aprender preferências, projetos e restrições do usuário para que futuras conversas comecem com contexto compartilhado, não do zero. O novo sistema está disponível para usuários Plus e Pro nos Estados Unidos e deve chegar a mais países e planos nas próximas semanas.
O detalhe mais importante para produto é a página de resumo de memória. As memórias sintetizadas podem ser revisadas em um resumo visível, onde o usuário consegue entender o que o ChatGPT sabe, atualizar informações e orientar quando certos assuntos devem aparecer.
Para leigo: a IA está ficando menos parecida com um atendimento em que você precisa explicar tudo de novo a cada ligação. Ela começa a parecer mais com alguém que acompanha seu histórico. Só que esse histórico precisa de painel, não de caixa-preta.
Por que isso importa: personalização de IA não é só "lembrar mais". É lembrar a coisa certa, no momento certo, com possibilidade de correção pelo usuário.
Para builders, founders, marketers e PMEs, isso muda o desenho de produto.
Se você cria um assistente para vendas, suporte, educação, saúde, conteúdo, CRM ou atendimento no WhatsApp, a pergunta não é apenas "como salvo o histórico?". A pergunta adulta é:
- o que vale a pena lembrar;
- o que nunca deve ser salvo;
- o que expira depois de dias ou meses;
- quem pode ver a memória;
- como o usuário corrige uma lembrança errada;
- como a IA sabe que uma preferência mudou;
- quando a memória deve ficar fora da resposta.
Memória boa economiza tempo. Memória ruim cria confiança falsa.
2. O paper novo mostra que lembrar e ler ainda é difícil
No arXiv, o paper MemoryDocDataSet: A Benchmark for Joint Conversational Memory and Long Document Reasoning colocou um problema bem prático na mesa: uma IA precisa combinar histórico de várias conversas com leitura profunda de documentos longos.
O benchmark tem 50 micro-mundos e 1.000 pares de pergunta e resposta. Cada caso combina de 3 a 5 personas, uma linha do tempo de eventos ao longo de meses, documentos reais de 20 mil a 50 mil tokens e conversas em múltiplas sessões baseadas nesses documentos.
O dado que importa: 75,1% das perguntas são híbridas. Ou seja, a IA precisa primeiro lembrar da conversa para descobrir qual documento é relevante e depois procurar a resposta dentro desse documento. O melhor baseline avaliado, chamado RAG-Both, fez 0,358 de F1 geral e 0,342 nas perguntas híbridas.
Em português simples: não basta jogar conversa velha e PDF grande dentro da IA. Ela pode até ter acesso a tudo, mas ainda se perder na ordem dos fatos, escolher o documento errado ou responder com um pedaço correto no contexto errado.
Por que isso importa: muitos produtos vendem "IA com seus documentos e seu histórico" como se isso resolvesse o problema. Na prática, juntar memória de conversa com documento longo ainda precisa de teste específico.
Isso vale para casos do mundo real:
- vendedor que pergunta sobre um cliente antigo e uma proposta recente;
- advogado que cruza histórico de reunião com contrato longo;
- clínica que junta preferência do paciente com orientação atualizada;
- escola que mistura progresso do aluno com material didático;
- agência que cruza briefing antigo, campanha nova e regra de marca;
- suporte que precisa lembrar o problema anterior e ler a política correta.
O erro típico não é a IA "não saber nada". É ela saber pedaços demais e costurar mal.
Para quem constrói, a lição é direta: crie testes híbridos. Não teste só "a IA encontra isso no documento?". Teste também "a IA sabe qual documento deve usar com base no histórico deste usuário?".
3. GitHub mostra que contexto grande tem preço
O GitHub publicou em 4 de junho que o Copilot ganhou janelas de contexto maiores e níveis configuráveis de raciocínio. A novidade inclui contexto de até 1 milhão de tokens em VS Code, Copilot CLI e GitHub Copilot app, além de níveis de raciocínio para equilibrar velocidade e profundidade.
O aviso mais útil está no próprio anúncio: escolher uma janela de contexto maior ou raciocínio mais alto consome mais créditos de IA por interação. O GitHub recomenda usar configuração padrão para tarefas do dia a dia e reservar contexto estendido ou raciocínio maior para problemas complexos, multi-arquivo ou difíceis.
Para leigo: contexto é como levar uma mala para a IA. Uma mala maior ajuda quando você precisa viajar longe. Mas não faz sentido carregar a casa inteira para comprar pão.
Por que isso importa: contexto grande reduz perda de informação, mas aumenta custo, latência e chance de carregar ruído. Mais contexto não é estratégia. É recurso caro que precisa de critério.
Esse ponto complementa o post de ontem sobre a IA deixando de ser um modelo só, mas o recorte de hoje é diferente. Ontem a decisão era escolher o tipo de modelo para cada tarefa. Hoje a decisão é escolher quanta memória e quanto contexto uma tarefa realmente merece.
Para produto e automação, a regra prática fica assim:
- tarefa simples não precisa de histórico completo;
- tarefa crítica precisa de contexto validado, não só contexto grande;
- tarefa recorrente merece resumo persistente;
- tarefa sensível precisa de memória mínima;
- tarefa cara precisa de limite de créditos;
- tarefa com cliente precisa de explicação sobre o que foi lembrado.
Contexto demais pode ser preguiça de design. O produto bom não manda tudo para o modelo. Ele escolhe o que entra.
4. A interface começou a mostrar a bagunça do contexto
No mesmo dia, o GitHub publicou a atualização GitHub Copilot in Visual Studio - May update. Entre as novidades, duas são especialmente importantes para quem pensa em produto.
A primeira é um anel de uso de contexto no topo do prompt do Copilot Chat. O usuário vê quanto da janela de contexto já foi consumida, pode abrir uma visão detalhada e usar "Summarize conversation" para compactar turnos antigos e liberar espaço.
A segunda é anexar commits como contexto. Em vez de explicar manualmente uma mudança antiga, o usuário pode selecionar um ou mais commits e colocar aquilo dentro da conversa.
O GitHub também tornou geral o Copilot Chat com contexto mais rico em pull requests. Quando o usuário pergunta sobre um diff ou PR, o chat adiciona contexto relevante do pull request e do repositório.
Para leigo: a IA está ganhando uma mesa mais organizada. Ela mostra quanto espaço mental já usou, permite resumir conversa antiga e puxa o documento certo quando você pergunta sobre uma mudança.
Por que isso importa: produtos com IA precisam mostrar e editar contexto, não só esconder tudo dentro de uma conversa infinita.
Isso vale fora de software também.
Imagine um assistente de marketing. Ele deveria mostrar quais briefings, campanhas, personas, ofertas e restrições entraram na resposta. Um assistente de vendas deveria mostrar quais interações, objeções e propostas anteriores foram consideradas. Um assistente de atendimento deveria deixar claro se usou histórico do cliente, política atual ou resposta genérica.
Quando a IA erra, o usuário precisa descobrir se o erro veio de:
- memória antiga;
- documento errado;
- conversa longa demais;
- resumo ruim;
- preferência desatualizada;
- instrução conflitante;
- falta de contexto crítico.
Sem isso, todo erro parece "a IA alucinou". Com isso, o time consegue corrigir o sistema.
5. Tarefa delegada também precisa herdar contexto certo
Outra atualização de 4 de junho foi a Agent tasks REST API. Usuários Copilot Pro, Pro+ e Max podem iniciar e acompanhar tarefas do agente em nuvem por API, em preview público.
O GitHub cita exemplos como rodar refatorações ou migrações em vários repositórios a partir de um script, criar repositórios por portal interno e preparar uma nova release semanal com notas.
Essa notícia parece de dev, mas a lição é ampla: quando a IA sai do chat e entra em tarefas em segundo plano, o briefing vira memória operacional. Se o briefing estiver incompleto, velho ou genérico, a tarefa sai torta em escala.
Por que isso importa: automação com IA não começa quando o agente executa. Começa quando você define qual contexto ele deve carregar para trabalhar sem você olhando.
Para qualquer PME, agência ou time de produto, isso se traduz em templates de contexto:
- campanha: público, oferta, canal, restrições e prazo;
- vendas: cliente, estágio, objeção, proposta e próxima ação;
- suporte: problema, plano, histórico, política e tom;
- financeiro: período, regra, exceção e limite de aprovação;
- conteúdo: persona, posicionamento, fonte, promessa e CTA;
- desenvolvimento: objetivo, escopo, padrão, teste e risco.
Quanto mais a tarefa roda sozinha, menos espaço existe para memória improvisada.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que contexto virou uma superfície de produto.
OpenAI está dizendo que memória precisa ser sintetizada, atualizada e revisável. A pesquisa do MemoryDocDataSet está mostrando que lembrar conversas e navegar documentos longos ainda é difícil. GitHub está colocando contexto grande, custo de raciocínio, resumo de conversa, commits e PRs dentro da interface. E a API de tarefas reforça que automação em segundo plano precisa de briefing que sobreviva ao chat.
O fio comum é simples:
- memória boa economiza explicação;
- memória velha vira erro;
- documento longo não resolve sozinho;
- contexto grande custa mais;
- resumo pode perder detalhe;
- usuário precisa ver o que a IA está usando;
- tarefa delegada precisa de briefing persistente.
Essa fase é menos vistosa que lançamento de modelo. Mas é mais importante para produto real. A diferença entre IA útil e IA irritante começa a estar na higiene do contexto.
O que isso muda pra quem constrói
1. Escreva uma política simples de memória. Defina o que a IA pode lembrar, o que nunca deve lembrar, o que expira e o que precisa de confirmação humana. Uma tabela pequena já muda a qualidade do produto.
2. Separe preferência de fato. "Prefiro respostas curtas" pode durar meses. "O cliente viaja na sexta" expira. "O preço do pacote é R$ 900" pode mudar. Não trate tudo como memória permanente.
3. Mostre a memória para o usuário. Se a IA usa histórico, dê um painel, resumo ou lista editável. O usuário precisa corrigir uma lembrança sem abrir chamado.
4. Teste perguntas híbridas. Crie casos em que a IA precisa usar conversa antiga e documento atual ao mesmo tempo. Esses são os testes que mais parecem vida real.
5. Controle custo de contexto. Contexto grande e raciocínio profundo devem ser reservados para tarefas difíceis. Para volume, use resumo, busca, cache e contexto mínimo.
6. Crie rotina de faxina. Toda memória precisa de revisão: cliente mudou, campanha acabou, regra de preço virou outra, pessoa saiu da empresa, projeto foi encerrado. Sem faxina, personalização vira entulho.
7. Use memória como parte da proposta de valor. Para quem vende consultoria, automação ou SaaS, "a IA aprende seu processo com controle" é mais defensável do que "a IA sabe tudo sobre você".
Quem acompanha /noticias vai continuar vendo modelo, agente, custo e ferramenta. O filtro de hoje é outro: essa novidade melhora a memória do trabalho ou só coloca mais coisa dentro da caixa-preta?
E o Brasil nessa história?
No Brasil, esse tema é muito concreto porque muita operação acontece em WhatsApp, planilha, CRM simples, e-mail, Drive, Notion, sistema legado e conversa informal.
Uma IA que lembra bem pode ajudar demais:
- atendimento que sabe o histórico do cliente;
- vendedor que lembra objeções e prazo de compra;
- clínica que respeita preferência e restrição do paciente;
- agência que não reexplica a marca a cada campanha;
- escola que acompanha evolução do aluno;
- escritório que cruza reunião, contrato e política interna;
- PME que transforma conversa solta em rotina.
Mas o risco também é direto. LGPD, dado sensível, preço antigo, promoção vencida, endereço errado, preferência desatualizada e conversa privada podem virar problema quando entram na resposta errada.
Para builders, consultores e PMEs, a oportunidade é vender memória com controle:
- histórico claro;
- consentimento;
- prazo de validade;
- resumo revisável;
- fonte do contexto;
- botão de esquecer;
- fallback humano quando a memória afeta dinheiro, saúde, jurídico ou reputação.
Não precisa começar com arquitetura complexa. Comece com uma pergunta de produto:
qual informação, se a IA lembrar errado, causa prejuízo real?
Essa informação merece regra especial.
A pergunta para hoje
Escolha um assistente, automação ou rotina com IA e responda:
O que a IA deve lembrar, por quanto tempo e como o usuário corrige quando ela estiver errada?
Se essa resposta não existe, o próximo passo não é aumentar o contexto. É fazer uma faxina na memória.
No Pro, a curadoria diária segue filtrando IA por decisão prática: produto, automação, marketing, stack, custo, contexto e negócio.