A notícia de hoje mostra que a cadeia de suprimento da IA mudou de fase, e isso importa porque a decisão deixou de ser apenas qual chatbot usar e passou a ser quem controla acesso, nuvem, talento, dados e memória do modelo.
Em português simples: o que aparece na tela é só a ponta. Por baixo existem governos discutindo regras com CEOs de IA, laboratórios disputando cientistas raros, modelos lembrando ou esquecendo marcas e pessoas, e projetos mostrando que tarefas úteis podem rodar em modelos pequenos, perto do dado da empresa.
Esse recorte não repete os últimos posts. Não é outro texto sobre vitrine de PME, segurança de agentes, aceitação pública, canais de confiança ou prestação de contas. O foco de hoje é dependência invisível: antes de escalar IA, entenda de qual camada você depende.
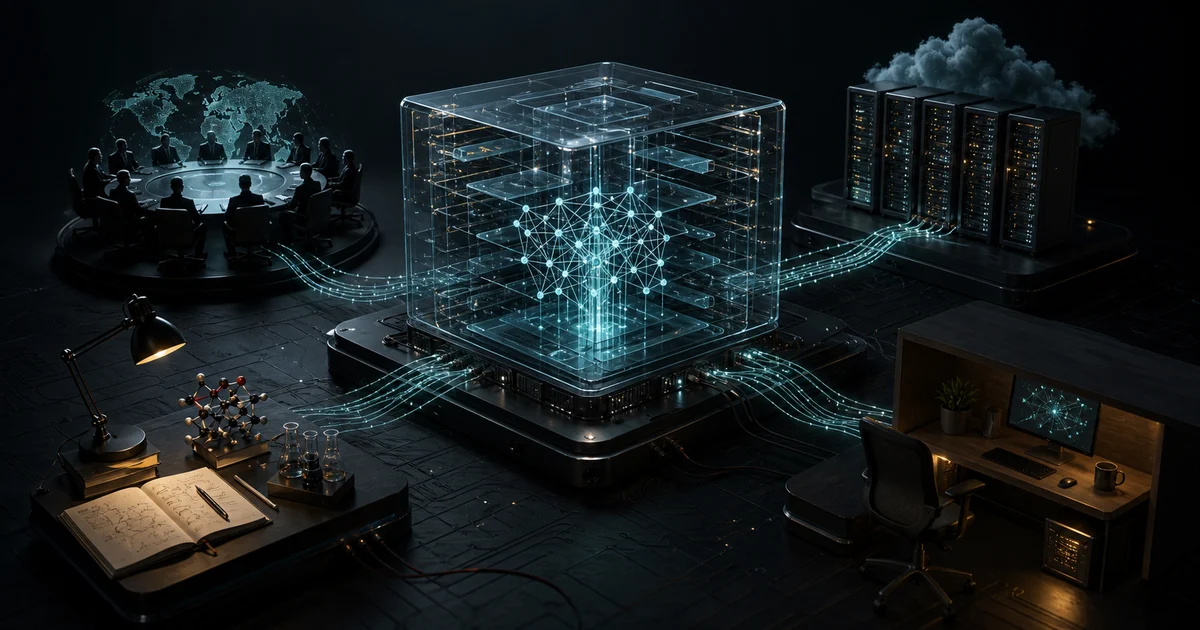 Capa editorial mostrando a cadeia de suprimento invisível da IA, com governo, nuvem, laboratório e computador local conectados a um núcleo de modelo
TL;DR do dia
- CEOs de IA sentaram à mesa do G7: a tecnologia virou assunto de Estado, padrão internacional e soberania.
- John Jumper saiu da DeepMind para a Anthropic: talento científico virou ativo estratégico na disputa entre laboratórios.
- A busca por reputação entrou nos pesos dos modelos: não basta ranquear no Google se assistentes já respondem sobre você sem abrir a web.
- Modelos pequenos ganharam um caso prático de back office: nem toda automação precisa depender do maior modelo alugado na nuvem.
- A decisão prática: trate IA como cadeia de suprimento. Mapeie fornecedor, modelo, dado, região, custo, fallback e o que precisa continuar funcionando se uma camada mudar.
1. O G7 mostrou que IA virou poder político
Segundo a Axios, CEOs de empresas como OpenAI, Google DeepMind, Anthropic, Meta e Mistral participaram de conversas no G7 em Évian-les-Bains, na França, ao lado de líderes de democracias. O ponto não é a foto. É o lugar que a IA ocupou: segurança, economia, soberania e padrões internacionais.
Sam Altman teria defendido que nenhum laboratório sozinho deve tomar as decisões centrais sobre IA. Dario Amodei pediu que democracias evitem se fragmentar na adoção de ferramentas avançadas. Demis Hassabis falou em padrões e cooperação internacional.
Para leigo: quando fabricantes de IA sentam com chefes de Estado, a ferramenta que você assina deixa de ser só software. Ela passa a carregar regra, país, negociação, exportação, disputa comercial e risco de disponibilidade.
Por que isso importa: uma automação pode funcionar tecnicamente e, ainda assim, ficar limitada por política, contrato, região ou regra nova.
Para quem constrói produto, isso muda uma pergunta básica. Não é só "qual modelo responde melhor?". É:
- onde esse modelo pode ser usado;
- em qual país o dado passa;
- qual fornecedor controla o acesso;
- que política pode mudar preço ou disponibilidade;
- qual alternativa entra se o modelo sair de uma região;
- quem responde se cliente, governo ou plataforma questionar o uso.
Esse é o lado menos glamouroso da IA. Mas é o lado que derruba produto quando ninguém olha antes.
2. A saída de John Jumper mostrou que talento também é infraestrutura
O TechCrunch noticiou que John Jumper, vencedor do Nobel de Química por seu trabalho no AlphaFold, está deixando o Google DeepMind para ir para a Anthropic depois de quase nove anos. A reportagem também cita o contexto de Noam Shazeer, cofundador da Character AI, deixando a DeepMind para ir para a OpenAI.
Isso parece notícia de bastidor. Não é.
Na prática, os modelos que chegam ao mercado dependem de gente raríssima: pesquisadores de ciência, engenheiros de produto, times de infra, especialistas em dados, pessoas que sabem transformar paper em ferramenta e ferramenta em receita.
Para leigo: quando uma empresa perde alguém que sabe construir uma parte difícil da IA, ela não perde apenas um crachá. Ela pode perder velocidade, direção e vantagem em uma área inteira.
Por que isso importa: roadmap de IA não nasce só de dinheiro e GPU. Nasce de talento concentrado. E talento concentrado muda de lugar.
Para builders e founders, a decisão prática é evitar apostar sua estratégia em uma fotografia estática do mercado.
O melhor modelo de hoje pode ficar para trás. O laboratório que parecia dominante pode perder equipe. A empresa que parecia atrasada pode contratar a pessoa certa. Uma feature que você prometeu para cliente pode mudar porque o fornecedor mudou foco.
Isso não significa trocar de ferramenta toda semana. Significa desenhar produto com menos dependência rígida:
- camada de modelo trocável;
- prompts e avaliações versionados;
- dados próprios fora do fornecedor;
- métricas para comparar alternativas;
- fallback para tarefas críticas;
- contrato que não promete capacidade que você não controla.
Se o talento é parte da infraestrutura, sua arquitetura precisa aceitar que a infraestrutura se move.
3. A reputação começou a ser medida dentro dos modelos
O TechCrunch também mostrou o In the Weights, um site criado por ex-funcionários da OpenAI para testar como diferentes modelos lembram pessoas sem usar busca na web. A ferramenta consulta modelos como GPT, Claude, Gemini, Grok e Llama e tenta medir se uma pessoa aparece nos "pesos" do modelo, ou seja, no conhecimento aprendido durante treinamento.
O serviço é meio brincadeira, meio sinal sério.
Durante anos, a pergunta de marketing era "o que aparece quando alguém me procura no Google?". Agora surge outra: "o que a IA já acha que sabe sobre mim, minha marca, meu produto ou minha categoria?".
Para leigo: quando um assistente responde sem abrir um site, ele pode estar usando uma mistura de treinamento antigo, memória estatística, fontes que viu no passado e busca ao vivo, dependendo da ferramenta. Você não controla tudo isso, mas pode melhorar os sinais públicos que alimentam esse ecossistema.
Por que isso importa: SEO deixou de ser apenas página, título e backlink. Também virou clareza de entidade, consistência pública e reputação legível por máquinas.
Esse ponto conversa com o post antigo sobre a busca virar resposta, mas o recorte de hoje é outro. Não é só ser citado em uma resposta com links. É preparar sua presença para que modelos, buscadores e assistentes entendam quem você é sem depender de adivinhação.
Para criadores, PMEs e marcas, o trabalho prático é simples:
- tenha uma página "sobre" clara;
- mantenha nome, descrição, área, cidade, produto e autor consistentes;
- publique conteúdo que explique sua categoria em linguagem direta;
- use dados estruturados quando fizer sentido;
- reduza perfis abandonados e descrições conflitantes;
- crie páginas canônicas para produtos, serviços e pessoas importantes;
- monitore o que assistentes respondem sobre você.
Não dá para "otimizar os pesos" como se fosse uma meta tag. Mas dá para parar de alimentar a internet com sinais confusos.
4. Modelos pequenos mostraram que dependência pode diminuir
No outro extremo da cadeia, um artigo da comunidade da Hugging Face mostrou um projeto de back office com modelos pequenos rodando em hardware comum. A ideia nasceu no hackathon Build Small, da Hugging Face e Gradio, com uma provocação útil: em vez de alugar sempre o maior modelo, construir algo útil com modelos pequenos o suficiente para rodar em máquina que a empresa já possui.
O projeto lê documentos como notas, recibos, contratos e PDFs; transforma perguntas em consultas ao banco; responde em linguagem simples; e mantém os números ancorados nos dados reais, não na imaginação do modelo.
Para leigo: é uma IA que ajuda no escritório dos fundos. Ela lê papelada, consulta base interna e explica número, sem depender sempre de mandar tudo para um modelo gigante.
Por que isso importa: a melhor IA para uma tarefa nem sempre é a mais poderosa. Às vezes é a que roda perto do dado, custa menos, quebra menos e pode ser ajustada pela equipe.
Isso muda a decisão de stack.
Se a tarefa é escrever uma campanha complexa, negociar texto sensível ou analisar estratégia, talvez faça sentido usar modelo de fronteira. Mas se a tarefa é ler invoice, classificar documento, responder pergunta recorrente sobre ERP, extrair campo ou explicar número já calculado, um modelo menor pode bastar.
Para PME, isso importa muito. Dependência de IA cara na nuvem vira custo recorrente. Dependência de ferramenta fechada vira lock-in. Dependência de automação frágil vira fila quando muda o layout de um documento.
O caminho mais maduro é separar tarefas:
- o que precisa de modelo grande;
- o que pode rodar em modelo pequeno;
- o que deve ficar perto do dado;
- o que precisa de regra determinística;
- o que precisa de aprovação humana;
- o que não precisa de IA nenhuma.
Usar IA bem não é colocar o modelo mais caro em tudo. É usar a menor camada inteligente que resolve o problema.
5. O caso Microsoft-China reforça o risco de acesso indireto
Como contexto recente, a TNW resumiu uma reportagem da Bloomberg dizendo que a ByteDance estaria entre os maiores clientes de IA da Microsoft, comprando serviços de IA e nuvem em volume bilionário, com acesso a modelos da OpenAI via Azure mesmo em um mercado que OpenAI e Anthropic não atendem diretamente.
Esse item é sensível e depende de fonte secundária, por isso entra aqui como contexto, não como a tese inteira. Mas ele deixa o padrão mais claro: acesso a IA nem sempre passa pela empresa que criou o modelo. Pode passar por nuvem, parceiro, região, contrato e brechas comerciais.
Para leigo: às vezes você acha que está comprando "modelo X", mas na prática está comprando um pacote que envolve cloud, revendedor, política regional, monitoramento, roteamento e termos que mudam conforme o fornecedor.
Por que isso importa: quem controla a porta de entrada pode ser tão importante quanto quem criou o modelo.
Para produto e negócio, isso pede uma checagem simples:
- qual empresa é dona do modelo;
- qual empresa entrega a API;
- onde a inferência roda;
- quem emite a fatura;
- quem define limite e bloqueio;
- quais países, setores ou clientes têm restrição;
- qual fornecedor aparece no contrato com seu cliente.
Se você vende IA para terceiros, essa cadeia precisa estar clara. Cliente não quer descobrir no susto que a ferramenta depende de uma combinação jurídica, comercial e geográfica que ninguém explicou.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que a vantagem saiu da interface e foi para a camada invisível.
O G7 mostrou que IA virou conversa de Estado. A saída de John Jumper mostrou que talento raro mexe com o equilíbrio entre laboratórios. O In the Weights mostrou que reputação começa a aparecer dentro do que modelos lembram sem abrir a web. A Hugging Face mostrou que modelos pequenos podem resolver trabalho real de back office. O caso Microsoft-China reforça que acesso pode passar por nuvem e contrato, não apenas pelo criador do modelo.
O fio comum é simples:
- política define acesso;
- nuvem define distribuição;
- talento define velocidade;
- dados definem utilidade;
- pesos definem reputação;
- modelos pequenos definem custo e autonomia;
- contrato define o que você pode prometer.
A fase "qual IA eu uso?" ficou curta demais. A pergunta melhor agora é: de quais camadas minha IA depende para continuar funcionando?
O que isso muda pra quem constrói
1. Faça um mapa de dependência. Liste modelo, provedor de API, cloud, região, base de dados, ferramenta de automação, plugin, pessoa responsável, custo por uso e fallback. Se você não sabe desenhar a cadeia, ainda não sabe escalar.
2. Separe tarefas por tamanho de modelo. Use modelo grande onde há ambiguidade, raciocínio e linguagem complexa. Use modelo pequeno ou regra simples onde o trabalho é repetitivo, local e ancorado em dado estruturado.
3. Guarde seus dados fora da ferramenta. Histórico de cliente, documentos, FAQ, avaliações, conteúdo e métricas devem continuar sob seu controle. A IA pode operar em cima deles, mas não deveria ser o único lugar onde eles existem.
4. Trate SEO como reputação para assistentes. Página clara, autoria, consistência de nome, schema, conteúdo explicativo e presença pública coerente ajudam humanos e máquinas. O objetivo não é enganar modelo. É ser fácil de entender.
5. Tenha plano B antes do problema. Se uma API subir preço, um modelo sair da região, uma política mudar ou um fornecedor travar conta, qual fluxo continua? Produto sério responde isso antes do lançamento.
Quem acompanha /noticias vai continuar vendo modelos, agentes e ferramentas. O filtro de hoje é outro: essa novidade reduz ou aumenta sua dependência invisível?
E o Brasil nessa história?
No Brasil, essa virada pesa porque muita adoção de IA acontece por assinatura direta, automação improvisada e ferramenta estrangeira paga em dólar.
A PME brasileira não precisa virar especialista em geopolítica. Mas precisa entender o básico:
- se todo atendimento depende de uma API externa, o câmbio vira parte do custo;
- se todo conhecimento fica dentro de uma ferramenta fechada, trocar fornecedor fica caro;
- se a marca está mal descrita na web, assistentes podem entendê-la errado;
- se documento interno vai para nuvem sem critério, risco e LGPD entram na conta;
- se a automação só funciona no modelo mais caro, a margem sofre;
- se não existe fallback, uma mudança de política vira parada operacional.
A oportunidade brasileira é montar soluções que combinem pragmatismo e autonomia: modelos grandes para o que exige inteligência ampla, modelos menores para back office, dados próprios bem organizados, presença digital clara e contrato simples explicando dependência.
Isso vale para agência, SaaS, consultor, criador, clínica, escola, contabilidade, e-commerce, escritório e qualquer negócio que começou a "colocar IA" em processos sem olhar a fundação.
O post antigo sobre open source e lock-in já apontava esse risco. O recorte de hoje é mais amplo: mesmo quando a ferramenta é ótima, a cadeia por trás dela precisa ser entendida.
Se você quer aplicar IA sem depender de entusiasmo vazio, veja a curadoria em /noticias. E se quer transformar isso em produto, automação ou rotina comercial com critério, entre no /pro.
A pergunta final de hoje é:
qual dependência invisível derrubaria sua estratégia de IA se mudasse amanhã?
Descubra essa resposta antes de aumentar o uso.