NVIDIA mede ganho de 42,5% na geração de tokens com três otimizações no DGX Spark
A NVIDIA avaliou as técnicas com o modelo Ling-3.0-flash e 1.319 questões do GSM8K. A latência média caiu 24,5%, sem mudança de precisão detectável estatisticamente.
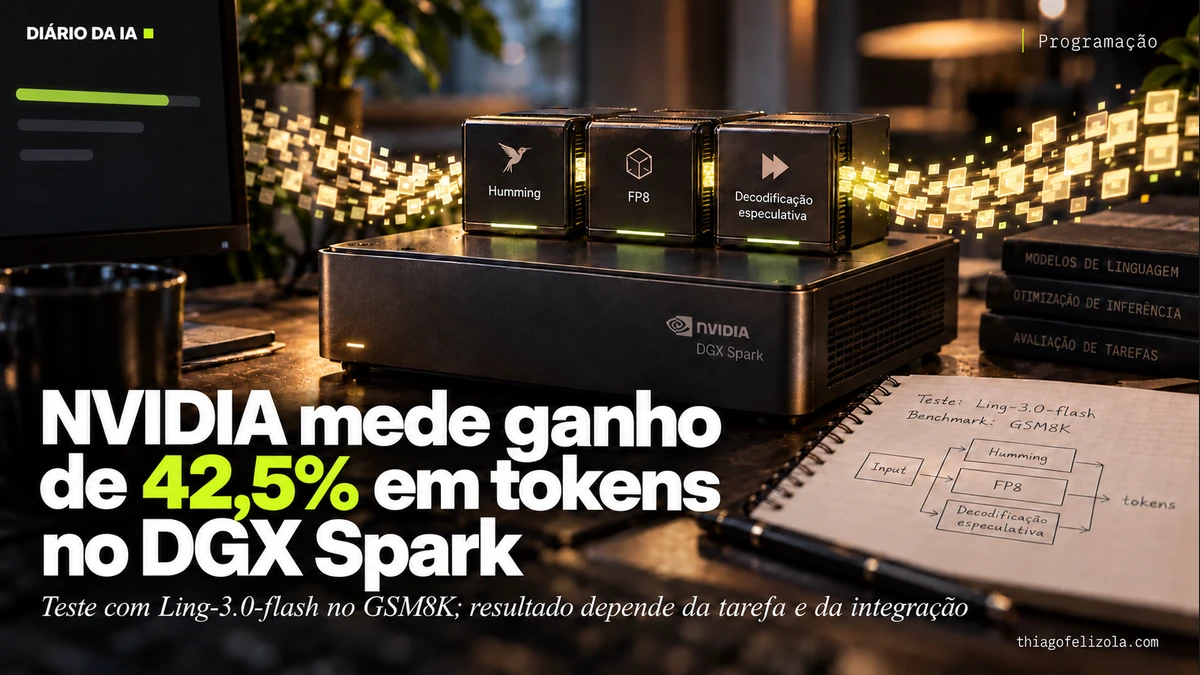
A NVIDIA detalhou três otimizações para a inferência do modelo Ling-3.0-flash no computador DGX Spark. Na avaliação completa com as 1.319 questões do GSM8K, a combinação aumentou em 42,5% a taxa de geração de tokens e reduziu em 24,5% a latência média de ponta a ponta, sem mudança de precisão detectável estatisticamente.
O teste usou o Ling-3.0-flash-fp4, modelo com 124 bilhões de parâmetros no total e 5,1 bilhões ativos por token. As técnicas foram trocar o mecanismo que executa os especialistas do modelo por uma biblioteca chamada Humming, reduzir de BF16 para FP8 o volume de dados lido pela camada de saída e usar decodificação especulativa: um modelo auxiliar propõe tokens para o modelo principal verificar em conjunto.
A NVIDIA também mediu aumento de 185,1% na taxa de geração em um teste sintético, mas alerta que esse resultado não prevê ganhos em outras tarefas. A combinação das três técnicas exige ainda que o modelo auxiliar compartilhe com o principal o módulo completo da camada de saída. Sem essa integração, o sistema pode aceitar menos tokens e ficar mais lento que a configuração sem otimizações. A empresa recomenda validar a ativação de cada ajuste durante a implantação.
O que muda para você
O resultado interessa a desenvolvedores que executam o Ling-3.0-flash no DGX Spark e conseguem configurar as otimizações descritas no cookbook do modelo. A NVIDIA não apresenta os números como garantia para outras tarefas: cada equipe precisa medir uma carga de trabalho parecida com a sua aplicação. Para quem não trabalha com esse modelo e equipamento, nada muda de imediato.
Minha leitura
Os números são promissores para quem roda esse modelo no DGX Spark, mas dependem de uma integração que pode falhar sem deixar isso evidente. Eu trataria a validação de cada ajuste como parte da implantação, não como detalhe posterior. O teste relevante é o da tarefa que a equipe pretende executar; o resultado sintético, sozinho, não diz quanto ela vai ganhar.
 Thiago FelizolaConsultor de IA, curador do Diário da IA