NVIDIA mostra como executar modelos de IA no DGX Spark com TensorRT Edge-LLM
O tutorial ensina a rodar o Nemotron-3.5 Lightning e disponibilizá-lo por uma API local no DGX Spark de 64 GB.
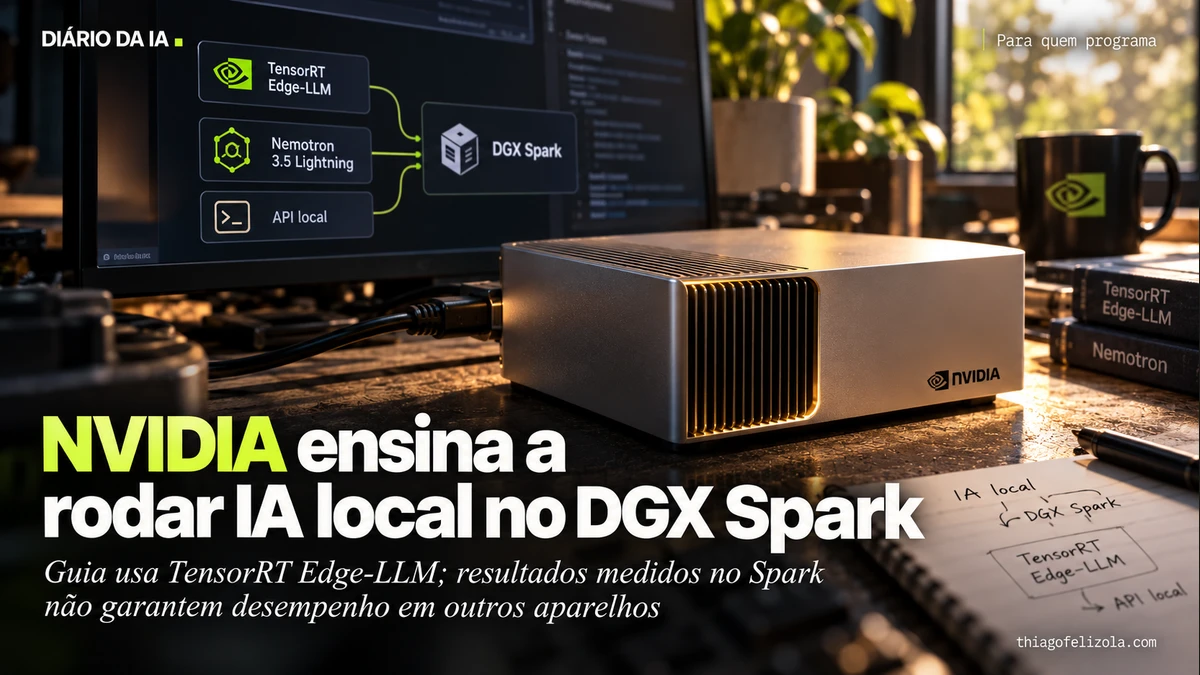
A NVIDIA publicou um tutorial para executar o modelo de texto Nemotron-3.5 Lightning no DGX Spark de 64 GB usando o TensorRT Edge-LLM. O guia mostra como iniciar conversas pelo terminal e disponibilizar o modelo por uma API local compatível com a OpenAI, para desenvolver e testar aplicações.
A ferramenta de linha de comando baixa o modelo escolhido e cria mecanismos TensorRT otimizados para o DGX Spark. Na primeira execução do exemplo, o download do modelo leva cerca de 21 GB; também é preciso reservar espaço para os mecanismos gerados. O tutorial requer uma pilha de software NVIDIA compatível, CUDA 13, TensorRT 10.16.1.11 ou mais recente da série 10.x e Python de 3.10 a 3.12.
O material também ensina a ativar a decodificação especulativa DSpark, que usa um modelo auxiliar para propor tokens ao modelo principal. A NVIDIA relata resultados de latência e velocidade de geração em condições específicas de teste. Com DSpark, o pico de memória total do sistema durante a inferência foi de 27,9 GB, incluindo o sistema operacional. O guia cita implantação em plataformas Jetson Thor, DRIVE AGX Thor e IGX Thor, mas os testes descritos foram feitos no DGX Spark de 64 GB.
O que muda para você
O guia serve a desenvolvedores com um DGX Spark de 64 GB e a pilha de software exigida. Eles podem testar o Nemotron-3.5 Lightning localmente e conectar protótipos à API; a primeira execução exige baixar cerca de 21 GB e gerar os mecanismos de inferência. O tutorial descreve um fluxo de desenvolvimento e não demonstra os mesmos resultados de desempenho nas outras plataformas citadas.
Minha leitura
O tutorial facilita testar um modelo no DGX Spark e preparar aplicações para plataformas embarcadas, mas os resultados de desempenho têm um limite claro: foram medidos no Spark, em condições específicas. Eu usaria esses números como referência para esse equipamento, não como garantia para Jetson Thor, DRIVE AGX Thor ou IGX Thor. A decisão depende do comportamento do modelo no hardware em que a aplicação vai rodar.
 Thiago FelizolaConsultor de IA, curador do Diário da IA