NVIDIA detalha limites de memória para GPUs compartilhadas no Kubernetes
A NVIDIA publicou um guia sobre o CUDA 13.4, o GPU Fractioning Operator e o KAI Scheduler para limitar a memória usada por cargas de trabalho em GPUs compartilhadas.
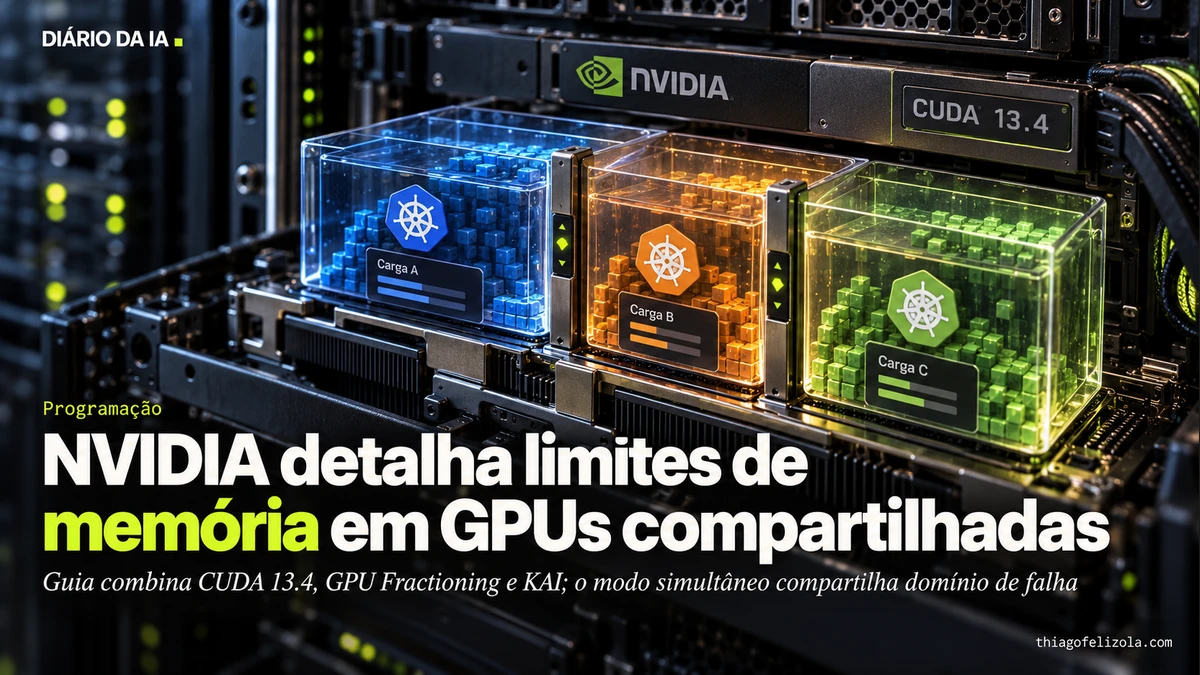
A NVIDIA publicou um guia sobre como aplicar limites de memória a cargas de trabalho que compartilham GPUs em clusters Kubernetes. A configuração combina o CUDA 13.4, o operador de código aberto GPU Fractioning e o KAI Scheduler. A integração com o operador está disponível no KAI Scheduler a partir da versão v0.18.0.
Segundo o guia, o CUDA 13.4 acrescenta um modo de compartilhamento por turnos com limite de memória. O compartilhamento de processamento simultâneo, já existente no MPS, também pode ser configurado. O operador roda em cada nó com GPU e aplica as definições registradas pelo agendador. Outros agendadores Kubernetes podem usar o recurso se escreverem as anotações necessárias.
No modo NvFractions, o KAI Scheduler escolhe as GPUs e registra a alocação de memória e o modo de compartilhamento. A memória pode ter um mínimo garantido e um limite maior para uso quando houver capacidade livre. Cada GPU opera em apenas um modo por vez. O guia ressalta que o compartilhamento simultâneo põe as cargas no mesmo domínio de falha; no modo por turnos, elas mantêm domínios separados.
O que muda para você
Isso serve a equipes que administram clusters Kubernetes com GPUs e precisam dividir recursos entre diferentes cargas. O operador e o KAI Scheduler estão no GitHub; o modo NvFractions está integrado a partir da versão v0.18.0 do KAI Scheduler. Para aplicar os limites, é preciso configurar as anotações das cargas e ter o operador instalado nos nós com GPU. O guia não apresenta uma oferta voltada a usuários finais.
Minha leitura
O ganho está em controlar a memória de cada carga, mas a configuração também exige decidir como elas compartilham o processamento. No modo simultâneo, uma falha pode afetar trabalhos vizinhos; no modo por turnos, os domínios de falha ficam separados. Para quem opera um cluster, esse risco precisa entrar na escolha do modo, junto com a capacidade que se quer aproveitar.
 Thiago FelizolaConsultor de IA, curador do Diário da IA