Microsoft detalha ThinkingBox, benchmark que mede agentes de IA pelo estado final dos dados
A Microsoft detalha o ThinkingBox, benchmark que avalia agentes de IA pelo estado terminal do banco de dados, não só pelas chamadas de ferramentas. Em 121.680 tentativas válidas, 79.853 falharam nas verificações executáveis.
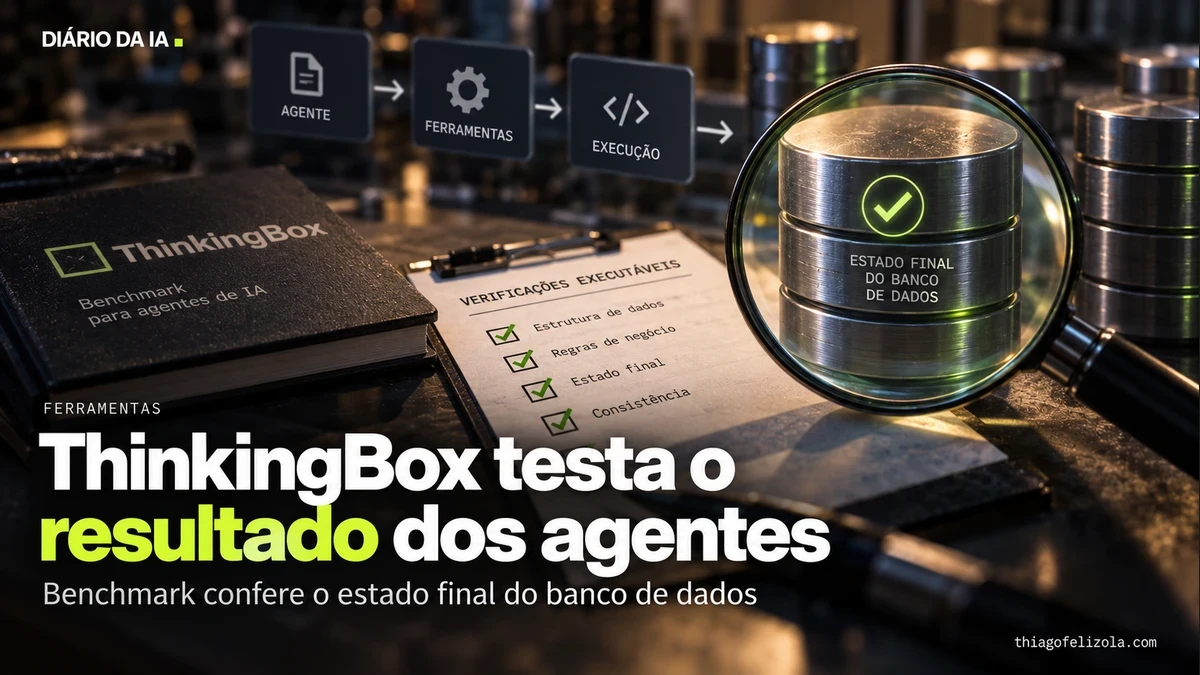
A Microsoft publicou no Hugging Face o ThinkingBox, um benchmark para agentes de IA que julga o estado final deixado no backend, e não só a correção das chamadas de ferramenta ou da resposta textual. Cada tarefa roda 20 vezes em sessões isoladas, e o resultado é comparado com o estado terminal exigido.
No exemplo descrito pela empresa, um agente faz nove chamadas corretas, abre e documenta um ticket, mas encerra o caso com o status errado e ainda responde sem enfrentar a dúvida principal da cliente. É esse tipo de desvio que o ThinkingBox tenta capturar: o trajeto pode parecer certo, mas o dado final pode continuar errado.
Em uma ablação com 121.680 tentativas válidas em 12 modelos, 79.853 falharam nas verificações executáveis. Entre essas falhas, 67,24% terminaram sem erro aparente, mas ainda assim deixaram valores errados, efeitos extras ou faltas no estado final. O benchmark cobre 507 fluxos de trabalho e também calcula custo por sucesso e por tarefa confiável.
O que muda para você
Serve para quem avalia ou constrói agentes que alteram registros, abrem tickets, fazem reembolsos ou mexem em sistemas transacionais. O ganho prático está em medir o que ficou gravado no backend, não só a fala do modelo. Segundo a Microsoft, ThinkingBox e ThinkingBox-Bench estão no Hugging Face e podem ser usados via OpenEnv; o material pede Linux ou WSL, Python 3.11+, uv e Docker.
Minha leitura
A métrica certa muda a conversa. Se o agente pode soar correto e ainda assim gravar o estado errado, pass@1 virou um número bonito demais para trabalho de verdade. O recado aqui é separar capacidade de confiabilidade. Para mim, a pergunta útil deixa de ser qual modelo respondeu melhor e passa a ser qual consegue terminar o fluxo sem deixar lixo no sistema.
 Thiago FelizolaConsultor de IA, curador do Diário da IA