AWS mostra como preparar páginas com Crawl4AI para bases do Bedrock
A AWS publicou um guia para usar o rastreador de código aberto Crawl4AI na preparação de conteúdo para as Knowledge Bases do Amazon Bedrock. O fluxo permite selecionar trechos de páginas e adicionar metadados antes da ingestão.
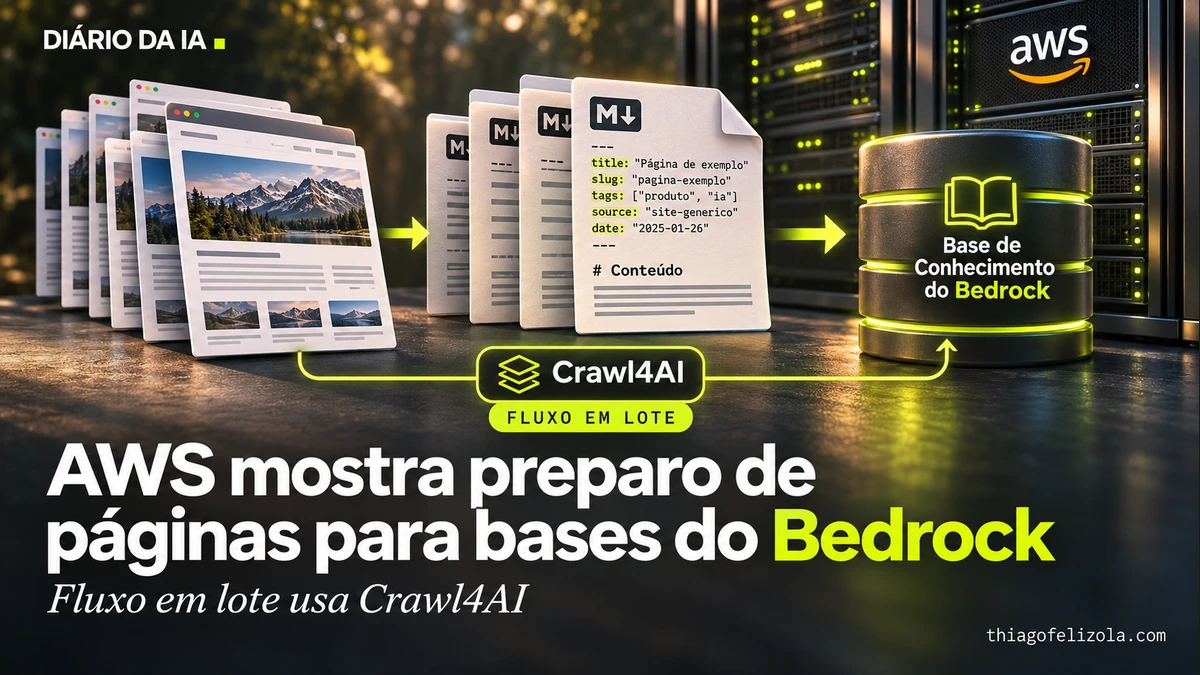
A AWS publicou um guia sobre como usar o Crawl4AI, rastreador de sites de código aberto, para preparar conteúdo antes de enviá-lo às Knowledge Bases do Amazon Bedrock. O exemplo salva cada página preparada em Markdown e seus metadados em arquivos associados no Amazon S3, de onde a base de conhecimento ingere os dados.
A etapa adicional serve a fontes que exigem mais controle do que o conector Web Crawler do Bedrock oferece: por exemplo, indexar apenas o conteúdo principal, retirar menus e outros elementos repetidos ou anexar atributos próprios. A AWS recomenda começar pelo conector gerenciado para a maioria dos sites públicos que ele consegue alcançar e indexar.
O fluxo descrito faz ingestão em lote de sites conhecidos. Não oferece acesso à web em tempo real durante a geração de respostas e não processa sessões autenticadas. A implementação é um exemplo, não um requisito do Bedrock. A AWS também alerta que filtros por metadados podem refinar a busca, mas não funcionam como controle de autorização.
O que muda para você
O guia é voltado a equipes que montam bases de conhecimento no Amazon Bedrock e precisam preparar páginas antes da ingestão. O repositório de exemplo permite implantar o fluxo na própria conta da AWS, mas exige configurar os sites autorizados, o S3 e a base. Ele não cobre páginas que exigem login nem consulta a conteúdo novo em tempo real. Para quem usa apenas um assistente pronto, nada muda de imediato.
Minha leitura
Mais controle sobre o conteúdo pode melhorar uma busca com RAG, mas também exige manter uma etapa própria de preparação. O exemplo da AWS não resolve páginas protegidas por login nem transforma a base em busca pela web em tempo real. Eu avaliaria primeiro se o conector padrão realmente inclui menus ou outros trechos que atrapalham as respostas; se não inclui, a complexidade extra pode não se justificar.
 Thiago FelizolaConsultor de IA, curador do Diário da IA