AWS detalha ajuste de agente de busca com reforço multiturno no SageMaker AI
A AWS publicou um post técnico mostrando como ajustar um agente de busca com aprendizado por reforço multiturno no Amazon SageMaker AI. O texto relata ganhos em qualidade de recuperação e confiabilidade frente ao modelo base.
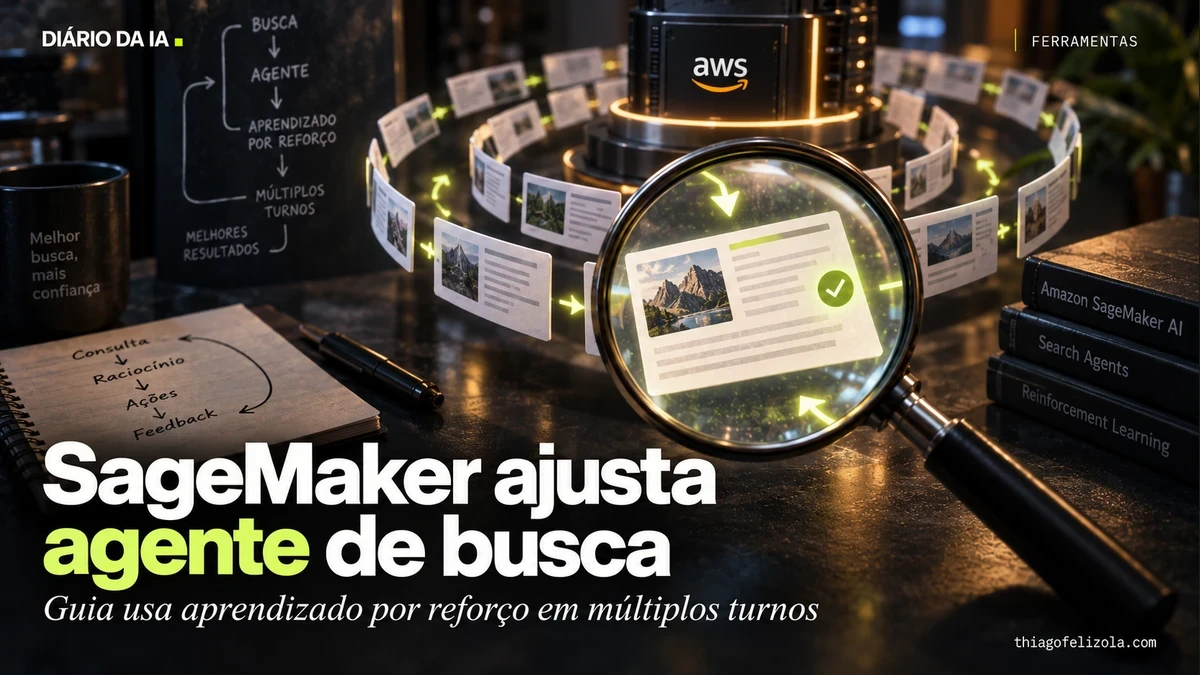
A AWS publicou um post técnico descrevendo como ajustar um agente de busca com modelo de linguagem usando aprendizado por reforço multiturno no Amazon SageMaker AI. O método treina o agente em sequências completas de decisões, em vez de otimizar cada passo isoladamente, para capturar dependências entre turnos de interação.
Segundo a empresa, o ajuste fino melhorou a qualidade de recuperação em três de quatro conjuntos de teste. Os maiores ganhos foram no BrowseComp-Plus, com alta de 23,7% em nDCG@10, e no WixQA, com 18,4%. No FreshStack houve leve regressão. A confiabilidade foi o resultado mais forte: no BrowseComp-Plus, a taxa de falhas caiu de 22,89% para 0,68%, indicando que o agente passou a concluir melhor as tarefas dentro do limite de turnos e tokens.
O post também diz que a configuração do treinamento exigiu três hiperparâmetros ajustados, mantendo o restante nos padrões. A AWS informa que o Qwen3.6-27B usado no exemplo é suportado na região US West (Oregon) e que o treinamento pode ser retomado a partir de um checkpoint se houver parada por tempo limite ou erro de infraestrutura.
O que muda para você
Para quem desenvolve agentes de busca, o texto mostra um caminho para melhorar qualidade e confiabilidade sem depender de um modelo maior. Já dá para usar o método como referência técnica no SageMaker AI, mas a publicação não diz que isso esteja disponível fora do fluxo descrito no post. Serve para equipes que precisam controlar turnos, custo e taxa de falha.
Minha leitura
O número que realmente pesa aqui é a queda de falhas. Quando o agente deixa de travar antes de terminar a busca, ele sai da categoria de demo bonita e entra na categoria de ferramenta que pode ser colocada para trabalhar. O limite também aparece claro: isso é um post técnico com um conjunto específico de testes, não uma promessa universal. Para mim, a pergunta certa é simples: seu caso exige confiabilidade no final da sequência, ou só uma resposta plausível no meio do caminho?
 Thiago FelizolaConsultor de IA, curador do Diário da IA