A notícia de hoje mostra que a relação entre IA e conteúdo mudou de fase, e isso importa porque SEO, permissão de uso e pagamento começaram a virar partes separadas da mesma decisão.
Em português simples: antes, o acordo era "deixe o buscador ler seu site e ele manda visitantes de volta". Agora a IA pode ler, resumir, responder, agir, treinar modelo e nem sempre mandar a pessoa para a sua página. A pergunta prática virou: essa IA está me descobrindo, usando meu conteúdo, treinando com ele ou comprando acesso?
Esse recorte não repete os últimos posts. Não é outro texto sobre bancada especializada, compra corporativa, mundo físico, acesso a modelo ou saúde regulada. O foco de hoje é mídia, SEO, criadores e pequenos negócios: conteúdo deixou de ser só tráfego e virou recurso que precisa de regra de uso.
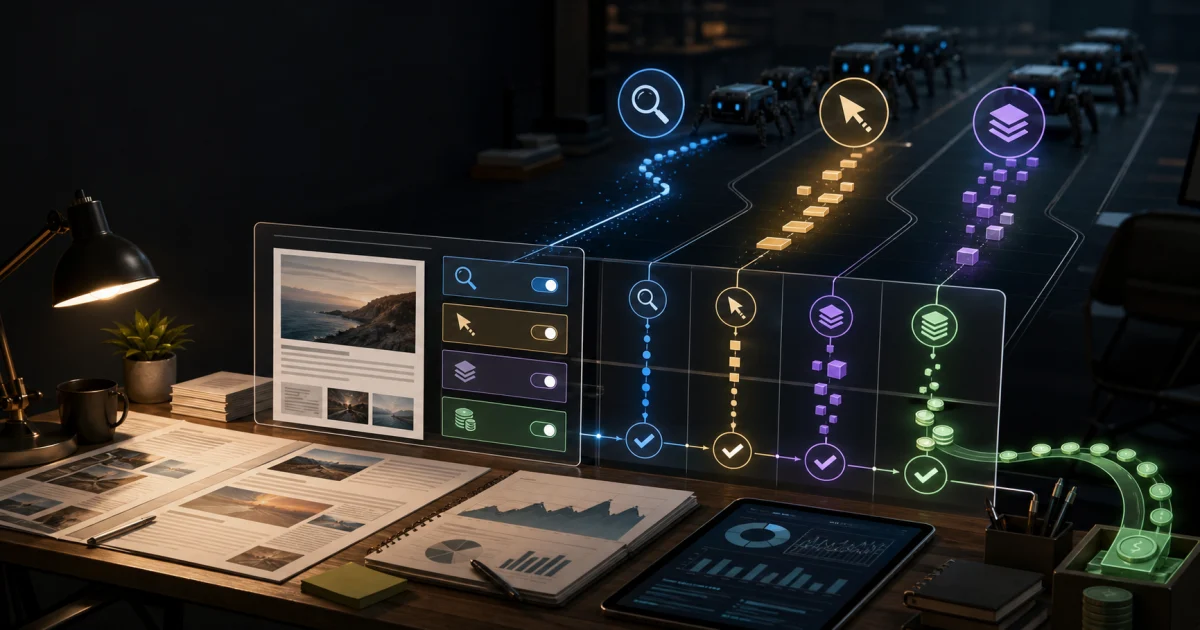 Capa editorial mostrando páginas de conteúdo em uma mesa, robôs de IA separados por trilhas de busca, agente, treinamento e pagamento
TL;DR: conteúdo virou recurso de IA
- Cloudflare separou bots por finalidade: donos de site passam a gerenciar Search, Agent e Training de forma mais explícita, inclusive no plano gratuito.
- Páginas com anúncio entram na discussão: a partir de 15 de setembro de 2026, novos domínios na Cloudflare terão Training e Agent bloqueados por padrão em páginas com ads, enquanto Search segue permitido.
- O robots.txt ficou mais semântico: a Cloudflare começou a testar um sinal de uso do conteúdo, com níveis como interação imediata, referência com link e reprodução completa.
- Pay Per Use começa a substituir Pay Per Crawl: experimentos com Ceramic.ai e You.com tentam pagar criadores quando o conteúdo aparece em respostas, não só quando é rastreado.
- Micropagamento entrou no protocolo: o Monetization Gateway com x402 quer permitir cobrança por página, dataset, API ou ferramenta MCP.
- A decisão prática: se você publica conteúdo, não otimize só para ranquear. Defina o que pode ser encontrado, o que pode ser reutilizado, o que precisa virar lead e o que merece ser cobrado.
1. A Cloudflare mostrou que "bot de IA" virou uma palavra grande demais
A Cloudflare anunciou novas opções para gerenciar tráfego de IA por finalidade. O ponto mais importante é a separação entre três comportamentos: Search, Agent e Training.
Para leigo:
- Search é quando um sistema rastreia seu site para ajudar alguém a encontrar uma resposta depois;
- Agent é quando um robô visita uma página para fazer uma tarefa em nome de uma pessoa;
- Training é quando o conteúdo é usado para treinar ou ajustar um modelo.
Essas coisas pareciam parecidas porque todas envolvem um robô lendo uma página. Mas, para quem publica, elas têm consequências bem diferentes.
Se um buscador lê seu conteúdo e manda visitantes, existe troca. Se um agente lê sua página para comprar algo, preencher um formulário ou comparar preços, o valor está na execução. Se um crawler leva o conteúdo para treinar um modelo, o valor pode virar capacidade permanente em outro produto.
Por que isso importa: chamar tudo de "crawler" escondia o principal. O dono do conteúdo precisa saber não só quem entrou no site, mas para fazer o quê.
Isso muda a estratégia de SEO. A pergunta não é mais só "o Google indexou minha página?". A pergunta passa a ser:
- quero aparecer em respostas de IA;
- quero permitir agentes em páginas transacionais;
- quero bloquear treinamento;
- quero liberar apenas trechos com link;
- quero cobrar por acesso a dado premium;
- quero manter páginas públicas para humanos e buscadores.
Quem acompanha /noticias vai continuar vendo lançamentos de modelos e ferramentas. Mas esse é um tipo diferente de notícia de IA: ela muda a regra de distribuição de quem cria conteúdo.
2. Páginas com anúncio ganharam uma nova cerca
O detalhe mais prático do anúncio é o padrão previsto para 15 de setembro de 2026. Segundo a Cloudflare, novos domínios terão Training e Agent bloqueados por padrão em páginas que exibem anúncios, enquanto Search continuará permitido por padrão.
A lógica é simples: se uma página tem anúncio, o modelo de negócio presume que uma pessoa vai visitar, ver a página e gerar receita. Se um robô lê tudo e entrega a resposta sem visita, a conta quebra.
A TechCrunch resumiu o movimento como um prazo para empresas separarem melhor os crawlers usados para busca daqueles usados para treinamento e agentes. O ponto não é "bloquear a IA inteira". O ponto é tirar a ambiguidade de bots de múltiplo uso.
Para leigo: é como uma loja permitir que alguém leia a vitrine, mas não permitir que a pessoa copie todo o catálogo, use o estoque para treinar um vendedor concorrente e ainda evite passar pelo caixa.
Por que isso importa: o velho SEO tratava o crawler como porta de entrada. A nova era precisa tratar crawler como contrato de uso.
Isso afeta blogs, sites de nicho, portais, marketplaces, afiliados, comparadores, bases de dados, documentações e comunidades.
Se você vive de tráfego, publicidade, afiliado, assinatura ou lead, precisa distinguir páginas:
- página que deve ser descoberta;
- página que deve gerar clique;
- página que pode virar resposta resumida;
- página que tem dado proprietário;
- página que deveria ser acessada só mediante login;
- página que poderia ser vendida como API ou feed.
O erro é tomar uma decisão única para o site inteiro. Em IA, conteúdo público não significa necessariamente "uso ilimitado para qualquer finalidade".
3. O robots.txt começou a falar sobre uso, não só acesso
Outro sinal importante é o teste de um novo parâmetro de preferência no robots.txt. A Cloudflare descreveu níveis de uso como immediate, reference e full.
Traduzindo:
immediate: o bot pode interagir naquele momento, sem guardar ou reutilizar;reference: pode indexar, citar trecho e linkar de volta;full: pode resumir e reproduzir de forma mais ampla.
Isso ainda é sinal de preferência, não uma lei automática da internet. Mas a direção é relevante. O robots.txt nasceu como um recado simples para crawler: pode ou não pode acessar. Agora a conversa começa a ficar mais parecida com: pode acessar, mas para qual tipo de uso?
Por que isso importa: a web está tentando criar uma linguagem comum para diferenciar descoberta, referência e reaproveitamento.
Para quem constrói produto, isso tem uma consequência prática. Conteúdo próprio precisa de política, não só publicação.
Uma empresa pequena pode não ter time jurídico, mas ainda pode organizar decisões simples:
- posts públicos podem ser usados para descoberta;
- materiais ricos ficam atrás de cadastro;
- base de dados vira produto separado;
- documentação técnica pode aceitar indexação, mas não reprodução completa;
- páginas de preço e disponibilidade devem ser acessíveis a agentes úteis;
- conteúdo autoral premium deve ter regra clara de licença.
Isso conversa com o post antigo sobre a busca virar resposta, mas o recorte de hoje é outro. Lá, a briga era ser citado. Aqui, a briga é controlar o tipo de uso antes da citação acontecer.
4. Pay Per Use é mais importante que Pay Per Crawl
A Cloudflare também publicou o texto Making AI search smarter, defendendo a passagem de Pay Per Crawl para Pay Per Use.
A diferença é grande.
Pay Per Crawl cobra quando o robô rastreia uma página. Isso é simples, mas imperfeito. Uma página pode ser rastreada várias vezes e nunca aparecer em uma resposta. Outra pode ser rastreada uma vez e virar base para milhares de respostas valiosas.
Pay Per Use tenta aproximar o pagamento do valor entregue. A Cloudflare citou experimentos com Ceramic.ai e You.com, incluindo modelos em que publishers optam por receber quando o conteúdo aparece em resultados ou respostas.
Para leigo: não é cobrar pela entrada no arquivo. É cobrar quando o arquivo ajudou alguém a resolver uma pergunta.
Por que isso importa: se a IA vira o lugar onde a resposta acontece, o criador não pode depender apenas do clique que talvez nunca venha.
Isso muda marketing e conteúdo.
O post de blog não morre, mas muda de papel. Ele precisa servir a quatro camadas:
- humano que lê no site;
- buscador tradicional que indexa;
- resposta de IA que precisa de fonte confiável;
- funil próprio que captura relação direta com o leitor.
Por isso o básico ficou mais importante, não menos: autoria clara, data, fonte, exemplo original, atualização, página rápida, entidade bem definida, links internos, newsletter, oferta própria e prova de experiência.
O conteúdo genérico, reescrito de outros sites, perde valor nesse mundo. Se a IA já consegue resumir o óbvio, o que sobra para o criador é dado próprio, opinião responsável, explicação simples, caso real e comunidade.
5. O pagamento pode acontecer dentro da própria requisição
O anúncio mais técnico do pacote foi o Cloudflare Monetization Gateway, em lista de espera. A proposta é permitir cobrança por páginas, datasets, APIs ou ferramentas MCP protegidas pela Cloudflare, usando o protocolo x402.
O nome vem do status HTTP 402, "Payment Required". Em vez de mandar o usuário para um checkout tradicional, a ideia é que a própria requisição diga: este recurso custa tanto; pague; volte com prova de pagamento; receba o conteúdo.
Isso parece distante para quem escreve post ou vende consultoria. Mas o princípio é simples: se agentes vão consumir recursos diretamente, talvez eles também precisem pagar diretamente.
Por que isso importa: no mundo de agentes, o comprador nem sempre será uma pessoa clicando em botão. Pode ser um software consumindo uma resposta, uma tabela, uma API, uma ferramenta ou um trecho de conteúdo.
Para builders, isso abre uma linha de produto:
- relatório pago por consulta;
- base de dados cobrada por chamada;
- ferramenta MCP com preço por uso;
- endpoint de comparação de preços;
- conteúdo premium liberado por micropagamento;
- API de nicho para agentes de terceiros.
Não é para todo mundo implementar amanhã. Stablecoin, wallet, tributação, fraude e suporte ainda exigem cuidado. Mas a direção importa: a monetização do conteúdo pode sair do "anúncio ou assinatura mensal" e entrar em uso medido por software.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que conteúdo deixou de ser apenas destino de tráfego e virou insumo negociável da IA.
A Cloudflare separou bots por Search, Agent e Training. As páginas com anúncio ganharam uma regra padrão diferente. O robots.txt começou a carregar sinal de uso. O Pay Per Use tenta pagar pelo valor gerado em respostas. O Monetization Gateway aponta para cobrança por requisição. O Attribution Business Insights promete mostrar crawl-to-referral por operador, volume de bot, origem e finalidade.
O fio comum é simples:
- aparecer não basta;
- receber clique não é garantido;
- "bot de IA" precisa explicar a finalidade;
- conteúdo original precisa de política de uso;
- SEO precisa conversar com AEO e GEO;
- dados de crawler viram argumento comercial;
- pagamento pode migrar do anúncio para a requisição.
Essa leitura corta uma ilusão comum: achar que a resposta é bloquear tudo.
Não é.
Para muitos sites, bloquear busca mata descoberta. Para outros, liberar tudo entrega valor sem retorno. O caminho mais inteligente é separar camadas: o que deve ser descoberto, o que pode ser referenciado, o que pode ser usado por agente, o que não pode treinar modelo e o que deve ser cobrado.
O que isso muda pra quem constrói
1. Escreva pensando em gente e em resposta de IA. O conteúdo precisa ser claro para humanos, mas também precisa ter fonte, data, autoria, estrutura e contexto para ser citado corretamente.
2. Separe conteúdo de topo, conteúdo de confiança e conteúdo premium. Nem tudo precisa ficar aberto do mesmo jeito. Post educativo, documentação, dado proprietário e relatório pago têm funções diferentes.
3. Pare de medir só pageview. Observe também referência em IA, menções de marca, leads diretos, inscrição em lista, busca de nome e crawl-to-referral quando a infraestrutura permitir.
4. Crie oferta própria. Se a IA responde parte da pergunta antes do clique, seu site precisa ter motivo para a pessoa continuar: diagnóstico, ferramenta, consultoria, comunidade, produto, newsletter ou /pro.
5. Defina uma regra simples para robôs. Mesmo que você não use recursos avançados agora, documente internamente: o que pode indexar, o que pode resumir, o que não pode treinar e que conteúdo deveria virar produto pago.
Para founders, marketers, criadores e PMEs, a decisão prática é esta: não trate SEO como uma lista de palavras-chave. Trate conteúdo como ativo com política de uso, distribuição e monetização.
E o Brasil nessa história?
No Brasil, essa virada tende a chegar de forma desigual. Grandes portais e publishers vão negociar primeiro. PMEs, blogs de nicho, creators e e-commerces pequenos vão sentir a mudança pelo lado mais silencioso: menos clique orgânico, mais resposta pronta na IA e mais dificuldade para saber onde o conteúdo foi usado.
Isso não significa abandonar blog, SEO ou conteúdo. Significa fazer com mais intenção.
Para uma empresa brasileira pequena, o checklist realista é:
- publique menos texto genérico e mais experiência própria;
- mantenha páginas de serviço claras, atualizadas e com prova;
- use links internos para transformar visita em jornada;
- capture relação direta com newsletter, WhatsApp, comunidade ou diagnóstico;
- monitore Search Console, GA4 e logs quando possível;
- proteja bases de dados e materiais premium;
- transforme conhecimento repetido em produto, template, ferramenta ou consultoria.
O Brasil também tem uma oportunidade: muito conteúdo bom em português ainda é raso, duplicado ou feito só para ranquear. Quem explicar bem, com exemplo local, fonte clara e oferta útil, pode virar referência tanto para humanos quanto para sistemas de IA.
O CTA final de hoje é direto: olhe para seu site e pergunte qual conteúdo merece ser encontrado, qual merece ser citado, qual merece virar lead e qual merece ser cobrado.
Se quiser acompanhar esse tipo de leitura prática, veja a página de /noticias. Se quiser transformar esse raciocínio em produto, automação ou estratégia de conteúdo, o caminho mais próximo é o /pro.