A notícia de hoje mostra que a segurança dos agentes de IA mudou de fase, e isso importa porque o risco não está só na resposta errada. Ele também está no ambiente onde a IA lê comentário, baixa pacote, acessa segredo, assina aplicativo, cria pull request e executa ferramenta.
Em português simples: quando a IA era só chat, o principal medo era ela inventar uma resposta. Quando ela vira agente dentro do código, do navegador, do CRM ou do computador da equipe, o medo muda. Agora a pergunta é: o que essa IA pode tocar se alguém tentar enganá-la?
Esse recorte não repete os últimos posts. Não é outro texto sobre aceitação pública, canais de confiança, prestação de contas econômica, memória ou IA especialista. O foco de hoje é segurança operacional: antes de deixar um agente agir, você precisa desenhar o guarda-corpo dele.
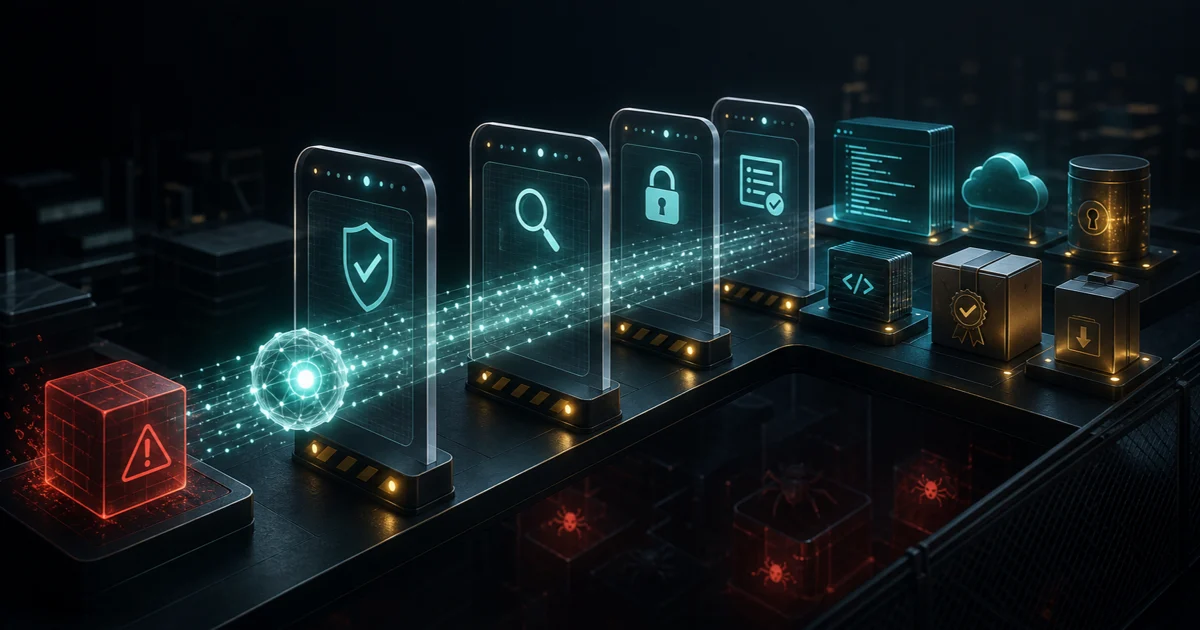 Capa editorial mostrando um agente de IA passando por barreiras de segurança antes de tocar código, chaves, certificados e ferramentas em nuvem
TL;DR do dia
- OpenAI precisou trocar certificados de apps: depois do ataque à cadeia de suprimentos do TanStack npm, usuários de macOS têm prazo para atualizar apps como ChatGPT, Codex e Atlas por canais oficiais.
- Microsoft mostrou um risco real em CI/CD com IA: um agente lendo issues, PRs e comentários podia ser induzido a acessar segredos do runner.
- O paper GitInject mostrou que o problema é estrutural: em testes com quatro provedores, todos foram suscetíveis a pelo menos uma classe de ataque em configuração padrão.
- Hugging Face mostrou um desenho mais seguro com Serge: política no repositório, ferramentas somente leitura e revisão humana antes de publicar comentário.
- Microsoft também alertou para marcas de IA como isca: phishing, SEO malicioso e instaladores falsos estão usando nomes de IA para roubar dados e instalar malware.
- A decisão prática: trate todo agente de IA como um funcionário terceirizado com acesso limitado: ele pode ajudar, mas não deve ler tudo, executar tudo nem guardar todas as chaves.
1. OpenAI mostrou que app de IA também é cadeia de suprimentos
A OpenAI atualizou sua resposta ao ataque de supply chain envolvendo o TanStack npm. A empresa diz que dois dispositivos de funcionários foram afetados, que houve exfiltração limitada de credenciais em alguns repositórios internos e que não encontrou evidência de acesso a dados de usuários, comprometimento de produtos ou alteração de software publicado.
O ponto prático está nos certificados. Como repositórios afetados incluíam material ligado à assinatura de produtos, a OpenAI passou a rotacionar certificados de assinatura e estendeu para 26 de junho de 2026 o prazo para usuários de macOS atualizarem seus apps. A orientação é atualizar pelo próprio app ou por links oficiais. A empresa também recomenda não instalar supostos apps de OpenAI, ChatGPT ou Codex vindos por e-mail, mensagem, anúncio, compartilhamento de arquivo ou site de terceiros.
Para leigo: certificado de assinatura é como o selo que ajuda o sistema operacional a reconhecer que aquele app veio mesmo de quem diz ter vindo. Se esse elo vira dúvida, o problema não é só "tem um bug". É "como eu sei que o app que baixei é legítimo?".
Por que isso importa: ferramenta de IA virou software crítico. Se você instala o app errado, atualiza por link errado ou baixa um plugin falso, o risco chega antes mesmo de você conversar com a IA.
Para PMEs, criadores e times pequenos, a lição é simples:
- baixe ferramentas de IA só de domínio oficial;
- atualize apps quando o fornecedor pedir rotação de certificado;
- desconfie de instalador enviado por WhatsApp, e-mail ou anúncio;
- mantenha uma lista interna de ferramentas aprovadas;
- remova extensões e clientes antigos que ninguém usa mais;
- trate "plugin de IA gratuito" como software com risco, não como brinde.
Muita empresa se preocupa com o prompt e esquece o básico: de onde veio o app?
2. Microsoft mostrou que comentário pode virar comando
A Microsoft publicou uma análise sobre segurança de CI/CD em um mundo agentivo, usando o caso da GitHub Action do Claude Code. O achado central: quando agentes de IA processam conteúdo não confiável de GitHub, como issue, descrição de pull request e comentário, esse texto pode tentar influenciar o uso de ferramentas.
No caso analisado, a Microsoft diz que o Claude Code Action tinha proteção para subprocessos como Bash, mas a ferramenta de leitura não passava pelo mesmo isolamento. Com prompt injection, o agente podia ser induzido a ler dados sensíveis do ambiente do runner, incluindo ANTHROPIC_API_KEY e possivelmente outras credenciais disponíveis. A Anthropic mitigou o problema no Claude Code 2.1.128, bloqueando acesso a arquivos sensíveis em /proc.
Em português simples: um comentário malicioso em uma issue pode parecer só texto para você. Para um agente que lê texto e usa ferramentas, esse comentário pode parecer uma instrução.
Por que isso importa: na automação clássica, o código dizia exatamente o que fazer. Na automação com IA, linguagem natural também pode virar ação. Isso muda o perímetro de segurança.
Esse ponto é diferente do post antigo sobre a IA achar bugs e o gargalo virar correção. Lá, o foco era corrigir vulnerabilidades encontradas. Aqui, o foco é o próprio agente virar parte da superfície de ataque.
Para quem usa agente de código, a regra prática é dura:
- issue, comentário, commit message e descrição de PR são entrada não confiável;
- segredo não deve estar no mesmo ambiente onde a IA lê conteúdo aberto;
- token precisa ter permissão mínima;
- agente que lê input externo não deveria também escrever em produção;
- ações sensíveis precisam de aprovação humana;
- workflow de IA precisa de log e atualização, igual qualquer dependência crítica.
Se a IA pode ler um comentário de desconhecido e também mexer no repositório, você tem uma fronteira que precisa ser redesenhada.
3. GitInject mostrou que o problema não é um modelo específico
O paper GitInject: Real-World Prompt Injection Attacks in AI-Powered CI/CD Pipelines, submetido ao arXiv em 7 de junho, reforça que esse não é um problema isolado de uma ferramenta.
Os autores criaram um framework para testar ataques de prompt injection em workflows reais de GitHub, com repositórios efêmeros e execuções de CI/CD de verdade. A diferença é importante: muitos benchmarks simulam chamadas de ferramenta; esse trabalho tenta observar como credenciais, sandbox, permissões e configuração se comportam em ambiente mais próximo de produção.
O resultado editorial é forte. O estudo avaliou quatro provedores de agentes de IA, documentou onze classes de ataque e concluiu que todos os provedores testados foram suscetíveis a pelo menos uma classe de ataque em configuração padrão. O paper também diz que as vulnerabilidades mais críticas são estruturais: nascem de como CI/CD trata credenciais e arquivos de configuração, não apenas do comportamento de um modelo.
Para leigo: trocar de IA não resolve se a esteira continua entregando chave, ferramenta e permissão para qualquer texto que consiga convencer o agente.
Por que isso importa: segurança de agente não é escolher "o modelo mais obediente". É desenhar o ambiente para que uma obediência errada não cause estrago.
Isso muda a decisão de produto.
Se você constrói automação com IA, não teste só se ela acerta a tarefa. Teste se ela:
- ignora instruções escondidas em texto de cliente;
- recusa pedido fora do escopo;
- não acessa arquivo que não deveria;
- não vaza segredo no log;
- não executa shell sem motivo;
- não publica mudança sem revisão;
- não confunde dado de entrada com ordem do sistema.
O teste bom não é "a IA é inteligente?". O teste bom é "o que acontece quando alguém tenta enganar a IA?".
4. Hugging Face mostrou um caminho mais seguro para code review
A Hugging Face publicou o Serge, um revisor de código nativo do GitHub. A notícia não é importante apenas por ser mais uma ferramenta de review com IA. Ela é importante pelo desenho de confiança.
O Serge pode revisar pull requests usando um endpoint compatível com OpenAI, seguir regras do próprio repositório e publicar comentários no fluxo normal de review do GitHub. Mas alguns detalhes são mais relevantes do que a IA em si:
- a política de review fica em
.ai/review-rules.mdna branch principal; - um PR não pode reescrever a política usada para revisar ele mesmo;
- ferramentas internas são somente leitura e limitadas ao checkout;
- variáveis de ambiente sensíveis são removidas dos helper tools;
- em modo web, o comentário gerado pode ficar em rascunho para um humano editar, descartar ou publicar.
Para leigo: em vez de dar uma caneta permanente para a IA escrever no quadro, o sistema deixa a IA fazer uma sugestão em rascunho, com regra definida pelo dono do repositório e revisão humana antes de aparecer para todo mundo.
Por que isso importa: a resposta para risco de agente não é abandonar IA. É colocar a IA no menor espaço útil possível.
Esse é o padrão que mais interessa para builders:
- regra confiável vem da branch principal, não do PR que está sendo avaliado;
- ferramenta de leitura não precisa virar ferramenta de execução;
- comentário de IA pode nascer como rascunho;
- aprovação continua com maintainer;
- modelo pode ser trocado conforme custo, confiança e política.
Isso vale para código, mas também vale para marketing, atendimento, financeiro e vendas. A IA pode sugerir resposta, classificação, proposta ou checklist. Mas o fluxo precisa separar sugestão de ação final.
5. Microsoft mostrou que marca de IA virou isca
Em outro relatório, a Microsoft alertou que marcas de IA estão sendo usadas como isca em engenharia social. A empresa descreve campanhas que imitam ChatGPT, Microsoft Copilot, DeepSeek e Claude para phishing, malvertising, SEO malicioso, roubo de credenciais, fraude financeira e instalação de malware.
Alguns exemplos são bem concretos.
A Microsoft observou e-mails com tema ChatGPT pedindo atualização de pagamento e levando vítimas a páginas falsas para coletar dados pessoais e cartão. Também descreveu campanha com tema Claude que coletava credenciais e tokens de acesso. Em outro caso, anúncios e repositórios com nomes ligados a ferramentas de IA levavam a instaladores falsos e infostealers.
O trecho mais útil para quem constrói conteúdo e produto é o caso DeepSeek V4. Segundo a Microsoft, um repositório falso no GitHub usava marca roubada, dados reais de benchmark, tópicos de SEO e até um llms.txt para ser encontrado por busca clássica e por busca assistida por IA. Ou seja: o golpe também está ficando legível para mecanismos de descoberta.
Por que isso importa: quando todo mundo quer usar IA, o nome "IA" vira atalho para clique apressado. O atacante não precisa quebrar o modelo se conseguir fazer a pessoa instalar o falso.
Para equipes pequenas, isso muda comunicação interna e marketing:
- não mande link de ferramenta sem domínio verificável;
- não peça para cliente baixar "plugin de IA" por anexo;
- não confie em repositório só porque tem estrelas, benchmark e README bonito;
- confira autor, domínio, histórico de commits e canal oficial;
- treine o time para desconfiar de urgência: "atualize agora", "sua conta será bloqueada", "nova IA grátis".
Quanto mais popular a IA fica, mais o golpe parece com onboarding.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que agente virou software com perímetro próprio.
OpenAI mostrou que certificados, apps e downloads oficiais importam. Microsoft mostrou que comentários em GitHub podem tentar comandar agentes que têm ferramentas e segredos. O paper GitInject mostrou que a vulnerabilidade é estrutural em workflows agentivos de CI/CD. Hugging Face mostrou que o design mais seguro é limitar ferramenta, fonte de política e publicação. Microsoft também mostrou que o hype de IA virou isca para phishing, SEO malicioso e instalador falso.
O fio comum é simples:
- texto de usuário pode ser instrução maliciosa;
- pacote de dependência pode carregar risco;
- app assinado pode precisar de rotação;
- repositório bonito pode ser isca;
- segredo no runner pode virar alvo;
- ferramenta de leitura pode vazar mais do que deveria;
- IA que escreve ou executa precisa de aprovação.
A fase "a IA consegue fazer?" continua importante. Mas, quando a IA ganha mão para mexer no mundo, a pergunta adulta vira: o que impede essa mão de tocar onde não deveria?
O que isso muda pra quem constrói
1. Faça inventário de onde a IA entra. Liste apps, extensões, agentes, GitHub Actions, bots, conectores, MCPs, plugins, automações no navegador, integrações com CRM e ferramentas de atendimento. O risco começa no mapa.
2. Separe entrada não confiável de ferramenta poderosa. Comentário de cliente, issue pública, e-mail, ticket, transcrição, anexo e mensagem de WhatsApp não podem virar ordem de sistema. A IA deve tratar isso como dado, não como comando.
3. Tire segredo do caminho do agente. API key, token de deploy, credencial de nuvem, chave de pagamento e cookie de sessão não devem estar disponíveis para um agente que lê input externo. Se precisa de segredo, use escopo mínimo, ambiente separado e rotação.
4. Prefira rascunho antes de ação. Para código, conteúdo, atendimento, cobrança ou vendas, a IA deve sugerir e explicar antes de publicar, enviar, commitar, pagar ou deletar. Quanto maior o impacto, maior a necessidade de aprovação humana.
5. Atualize por fonte oficial. A segurança mais simples continua sendo subestimada. Ferramenta de IA precisa ser instalada, atualizada e removida por processo confiável. Isso vale para ChatGPT, Codex, Copilot, Claude, plugins de navegador e clientes de desktop.
6. Teste tentativa de engano, não só tarefa feliz. Peça para alguém escrever inputs maliciosos, instruções escondidas e pedidos fora de escopo. Veja se a IA obedece, ignora, registra ou escala. Produto sério testa abuso.
Quem acompanha /noticias vai continuar vendo modelos, agentes e novas ferramentas. O filtro de hoje é outro: essa IA tem fronteira de segurança antes de tocar código, dinheiro, cliente ou reputação?
E o Brasil nessa história?
No Brasil, essa virada é especialmente prática porque muita adoção de IA acontece em time pequeno, com pouca segurança formal e muita ferramenta instalada por iniciativa individual.
O dono da PME assina um app. O vendedor instala uma extensão. A agência conecta uma ferramenta ao Google Drive do cliente. O dev cola um token no GitHub Action. O social media baixa um gerador de vídeo por anúncio. O suporte coloca IA para responder WhatsApp. Cada decisão parece pequena. Juntas, elas viram superfície de ataque.
O risco brasileiro não é só "uma super IA perigosa". É a mistura de:
- pressa para automatizar;
- pouca separação entre conta pessoal e conta da empresa;
- senha reaproveitada;
- plugin instalado sem aprovação;
- WhatsApp como canal principal;
- planilha com dado sensível;
- repositório público mal configurado;
- cliente pedindo velocidade sem perguntar segurança.
Isso também cria oportunidade para builders, consultores e agências.
Quem vende IA para PME pode diferenciar oferecendo implantação com guarda-corpo:
- lista de ferramentas aprovadas;
- política simples de download e extensão;
- revisão de permissões no Google Workspace, GitHub, CRM e WhatsApp;
- agentes rodando primeiro em modo rascunho;
- logs mínimos para saber o que a IA fez;
- treinamento para reconhecer golpe com marca de IA;
- checklist antes de conectar chave, cliente ou cobrança.
Não precisa transformar toda pequena empresa em banco. Mas precisa parar de tratar IA como brinquedo sem acesso. Se ela toca dado, cliente, código ou dinheiro, ela já faz parte da segurança.
Se você aprofunda produto, automação e negócio no /pro, a pergunta prática de hoje é:
qual agente, plugin ou app de IA do seu fluxo teria acesso demais se alguém conseguisse enganá-lo amanhã?
Comece tirando poder daí. Depois pense em escalar.