A notícia de hoje mostra que a licença social da IA mudou de fase, e isso importa porque data centers, modelos abertos e agentes locais agora precisam mostrar quem controla, quem paga e quem se beneficia.
Em português simples: IA deixou de ser só um aplicativo na tela. Ela virou obra elétrica, consumo de água, disputa política, ferramenta de trabalho, agente rodando no computador e promessa de produtividade para empresas pequenas.
Esse recorte não repete os últimos posts. Não é outro texto sobre prazo de migração, mídia conversacional, marchas de raciocínio, preço escondido em dados ou treinamento de uso. O foco de hoje é prestação de contas: se a IA quer crescer dentro da sociedade, precisa explicar seu custo fora do app.
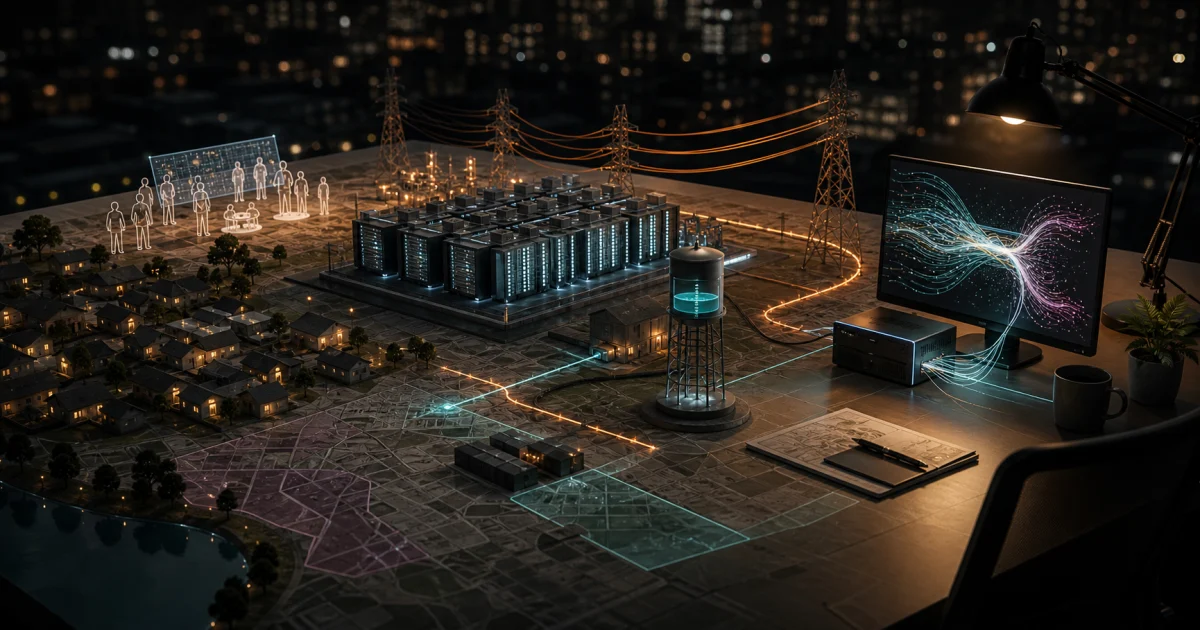 Capa editorial mostrando uma mesa de planejamento urbano com data center, rede elétrica, torre de água, bairro e uma estação local de IA conectados por luzes
TL;DR: a IA precisa prestar contas
- Meta publicou uma defesa política da IA aberta: Mark Zuckerberg argumenta que superinteligência deve chegar a bilhões de pessoas, mas também reconhece riscos de emprego, data centers, cibersegurança e controle.
- Muse Glimmer levou agente local para a mesa: o novo modelo aberto de 30 bilhões de parâmetros foi feito para rodar agentes em Macs e PCs com GPU, sem depender sempre da nuvem.
- OpenAI respondeu ao custo físico da IA: em carta ao governador do Texas, a empresa prometeu pagar sua própria infraestrutura, apoiar a rede elétrica, proteger água e informar comunidades.
- Sanders mostrou que pressão política virou produto: o senador pediu pausa a OpenAI, Anthropic e Meta, citando perda de controle e risco público. Concorde ou não, a cobrança chegou.
- GitHub colocou custo na tela do usuário: o Copilot no web agora mostra indicadores de gasto de tokens por sessão e mensagem.
- A decisão prática: antes de escalar IA, escreva onde ela roda, que dado toca, quem paga a conta, quem controla a ação e qual benefício mensurável ela entrega.
Notícias selecionadas
1. Meta transformou IA aberta em argumento de poder
A Meta publicou em 10 de agosto o texto The Future is for Everyone, um manifesto de Mark Zuckerberg sobre superinteligência pessoal, acesso amplo e modelos abertos.
A parte mais importante não é a retórica de futuro. É a tese política: se a IA ficar concentrada em poucas empresas, governos ou indivíduos, o poder fica desequilibrado. A solução defendida pela Meta é distribuir modelos e agentes para mais gente, de preferência com opções gratuitas ou baratas.
Para leigo: é a diferença entre uma cidade onde só uma empresa tem eletricidade e uma cidade onde todo mundo pode ligar a luz. A promessa da Meta é que IA aberta dá mais autonomia para indivíduos, criadores e pequenas empresas.
Só que o próprio texto reconhece o outro lado. Meta cita preocupações com deslocamento de trabalho, comunidades afetadas por data centers, uso indevido em cibersegurança e biologia, vigilância, liderança dos EUA e controle humano sobre sistemas avançados. Também anuncia um fundo para apoiar comunidades onde a empresa constrói infraestrutura.
Por que isso importa: quando uma empresa de IA precisa explicar emprego, energia, comunidade e controle, a conversa saiu do benchmark. Virou legitimidade.
Para builders, a lição é direta: não venda IA apenas como "mais produtividade". Explique quem ganha tempo, quem revisa, qual dado entra, qual energia operacional ela consome e onde aparece o benefício concreto.
2. Muse Glimmer colocou agente de IA para rodar mais perto do usuário
No mesmo dia, a Meta lançou Muse Glimmer, um modelo aberto de 30 bilhões de parâmetros, com pesos sob licença Apache 2.0, otimizado para agentes locais.
Segundo a Meta, o modelo foi desenhado para workflows de agente sempre ativos: uso de ferramentas, programação local, avaliação de respostas, raciocínio multimodal e recuperação quando uma ferramenta falha. O ponto prático é que ele foi comprimido para caber em hardware de consumidor, com quantização para menos de 20 GB no modelo de linguagem.
O model card no Hugging Face reforça o recorte: Muse Glimmer foi feito para tarefas agentic em hardware de usuário, sem exigir infraestrutura de nuvem ou acesso constante à rede.
Para leigo: até aqui, muita IA parecia uma central distante. Você manda tudo para fora e espera a resposta voltar. Um agente local muda a pergunta: que parte do trabalho pode acontecer no seu próprio computador, perto dos arquivos, com menos latência e menos custo por chamada?
Por que isso importa: agente local não é só economia. É uma escolha de controle. Para dados sensíveis, rotina offline, automação interna e trabalho repetitivo, rodar perto do usuário pode fazer mais sentido do que mandar tudo para a nuvem.
Isso não elimina responsabilidade. Modelo aberto também precisa de licença lida, atualização, avaliação, limite, logs e regra de uso. Local não significa automaticamente seguro. Significa que o builder ganha uma alternativa de arquitetura.
3. AMD e NVIDIA mostraram que local também é ecossistema
O lançamento de Muse Glimmer veio acompanhado de sinais de hardware. A AMD publicou testes para rodar o modelo em Ryzen AI Max e Radeon AI PRO, dizendo que agentes precisam de contexto grande, memória persistente, uso de ferramentas, privacidade e baixo custo operacional.
A NVIDIA também publicou um guia para rodar workflows locais com Muse Glimmer, incluindo caminhos com vLLM, SGLang, NIM e sandbox governado.
Para leigo: o modelo é só uma peça. Para usar de verdade, alguém precisa fazer a peça rodar rápido, com memória suficiente, ferramenta conectada, ambiente seguro e caminho de instalação.
Por que isso importa: a briga da IA local não é "baixei um modelo, resolvi". É escolher máquina, runtime, memória, velocidade, segurança e manutenção.
Para produto e PME, a decisão fica mais concreta. Se o fluxo envolve documento interno, imagem sensível, atendimento offline ou custo alto de token, vale testar local. Se envolve escala grande, atualização contínua e SLA, a nuvem pode continuar melhor. O ponto é parar de decidir no automático.
4. OpenAI colocou energia, água e vizinhança na conversa
A OpenAI publicou uma carta ao governador Greg Abbott sobre infraestrutura responsável de IA no Texas. A carta, datada de 7 de agosto, promete trabalhar com autoridades, utilities e comunidades para que projetos de IA tragam benefício local.
O documento fala em pagar os próprios custos de infraestrutura, não repassar despesas para clientes residenciais e pequenos negócios, apoiar nova geração de energia, operar de forma responsável em momentos de estresse da rede, minimizar consumo de água e fornecer informação sobre eletricidade, água, incentivos e proteções comunitárias.
Para leigo: data center de IA não é nuvem no sentido mágico da palavra. É prédio, fio, terreno, refrigeração, gente, barulho, água, energia e imposto em algum lugar.
Por que isso importa: IA em escala começa a ter perguntas parecidas com indústria pesada. Quem constrói precisa explicar impacto físico, não só mostrar demo bonita.
Mesmo que sua empresa não construa data center, essa lógica desce para produtos menores. Se a sua IA gasta muito, coleta muito dado, depende de fornecedor único ou muda rotina de trabalho, alguém vai perguntar qual é a conta completa.
5. Sanders e GitHub apontaram para a mesma palavra: controle
No Senado americano, Bernie Sanders publicou em 10 de agosto uma carta pedindo pausa no desenvolvimento de IA para OpenAI, Anthropic e Meta. A carta cita reportagens e compromissos públicos das empresas sobre pausar ou atrasar modelos quando a segurança não acompanha a capacidade.
É importante separar as coisas. A carta de Sanders é um documento político, não uma auditoria técnica independente. Mas ela mostra uma mudança prática: quando um sistema de IA é visto como fora de controle, o assunto sai do blog de pesquisa e entra no gabinete do regulador.
No mesmo dia, em uma escala muito menor, o GitHub anunciou que o Copilot no web agora mostra gasto de tokens por sessão e por mensagem. Parece detalhe de interface, mas carrega a mesma direção: uso de IA precisa ficar visível para quem está operando.
Por que isso importa: controle não é uma palavra só de governo. Também é UX. O usuário precisa ver custo, pausa, retomada, permissão, log e limite antes de confiar no agente.
O produto maduro não pede fé. Ele mostra o que a IA está fazendo, quanto custa, que dado tocou, onde falhou e quem pode interromper.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que crescer já não basta.
Meta defendeu IA aberta como distribuição de poder. Muse Glimmer mostrou que agentes locais estão ficando práticos. AMD e NVIDIA trataram local como ecossistema de hardware e runtime. OpenAI precisou falar de energia, água, comunidades e transparência. Sanders pediu pausa por risco público. GitHub colocou gasto de token dentro da experiência.
O fio comum é simples:
- IA em escala usa infraestrutura real;
- infraestrutura real afeta comunidades;
- agente local devolve parte do controle ao usuário;
- controle local ainda exige governança;
- custo precisa aparecer na tela;
- risco público chama regulador;
- benefício precisa ser explicado para além da demo.
Essa leitura corta uma ilusão comum: achar que IA cresce apenas quando o modelo melhora.
Não cresce só por isso.
IA cresce quando cabe na rede elétrica, na confiança do usuário, no orçamento da equipe, na política da empresa, na cidade onde o data center fica e na rotina de quem vai conviver com o agente.
Quem acompanha /noticias vai continuar vendo modelos, agentes e ferramentas novas. O filtro de hoje é outro: essa IA consegue prestar contas se alguém perguntar quem controla, quem paga e quem se beneficia?
O que isso muda pra quem constrói
1. Faça uma ficha de prestação de contas para cada IA. Nome do modelo, fornecedor, local de execução, dado acessado, custo esperado, dono interno, limite de autonomia e plano de desligamento.
2. Escolha local ou nuvem pelo risco do fluxo. Dado sensível, trabalho offline e automação repetitiva podem justificar teste local. Escala, SLA e atualização constante podem justificar nuvem. A escolha precisa ser consciente.
3. Mostre custo no momento de uso. Se a IA consome token, crédito, tempo de GPU ou orçamento de campanha, o usuário precisa ver antes que vire surpresa.
4. Trate data center como parte da cadeia do produto. Mesmo comprando API, seu produto depende de energia, água, região, capacidade e comunidade. Isso entra em risco de fornecedor.
5. Tenha botão de pausa e rastro. Agente que executa tarefa precisa de log, limite, confirmação para ação sensível e caminho claro para parar.
6. Venda benefício mensurável, não encanto. Se a promessa é economizar tempo, reduzir erro, vender mais ou atender melhor, defina a métrica antes de escalar.
Para builders, founders, marketers, criadores, PMEs e profissionais que usam IA para produto, automação e negócio, a decisão prática é esta: antes de colocar mais IA em produção, escreva uma página simples explicando controle, custo, dado e benefício do fluxo.
E o Brasil nessa história?
No Brasil, essa discussão chega de um jeito bem concreto.
A PME não está decidindo onde a Big Tech vai construir data center. Mas ela decide se cola dados de cliente em ferramenta externa, se deixa agente responder WhatsApp, se manda documento sensível para nuvem, se automatiza anúncio, se usa modelo local para rotina interna e se consegue explicar isso para cliente, equipe e parceiro.
Também existe uma oportunidade local. Muitos negócios brasileiros vivem de operação enxuta, margem apertada, atendimento por conversa e improviso inteligente. Se agentes locais ficarem mais fáceis, uma parte da IA pode rodar perto do trabalho real: no computador da agência, no notebook do contador, na clínica, na loja, no escritório pequeno.
Mas o atalho cobra método.
Uma rotina brasileira mínima pode começar com seis perguntas:
- essa IA roda na nuvem, no meu dispositivo ou nos dois?
- que dado de cliente ela vê?
- existe limite antes de enviar mensagem, gastar dinheiro ou alterar arquivo?
- qual custo aparece por uso?
- quem responde se ela errar?
- que benefício eu consigo provar em 30 dias?
Esse recorte conversa com o post sobre IA virar política industrial, mas o ponto de hoje é mais próximo da operação: não basta a IA existir como infraestrutura; cada produto precisa mostrar sua própria prestação de contas.
Se você quer transformar esse tipo de leitura em produto, automação, marketing ou rotina operacional com método, o caminho mais direto é entrar no /pro. E para acompanhar as próximas viradas práticas do mercado, veja a curadoria em /noticias.
A pergunta final de hoje é:
se seu produto de IA fosse cobrado publicamente amanhã, que prova você teria de que ele ajuda mais do que custa?
Comece por essa prova. IA que só cresce sem explicar a conta vira desconfiança. IA que presta contas ganha espaço para trabalhar.