A notícia de hoje mostra que a transparência da IA mudou de fase, e isso importa porque conteúdo sintético deixou de ser um detalhe escondido no bastidor da ferramenta. Agora ele começa a precisar aparecer no lugar onde a pessoa decide: no chat, no feed, no anúncio, no vídeo, no áudio e no texto público.
Em português simples: não basta mais dizer "usei IA internamente". Quando a IA fala com uma pessoa, cria uma imagem realista, edita uma voz, publica texto sobre assunto de interesse público ou entra em campanha, o usuário precisa entender o que está vendo e quem continua responsável.
Esse recorte não repete os últimos posts. Não é outro texto sobre funil comercial, IA de domínio, autonomia prática, política industrial ampla ou incidente de agente. Também não é a mesma tese do post antigo sobre criação com IA virar risco de uso: lá, o foco era licença e autorização para publicar. Hoje, o foco é a interface pública: como avisar, marcar e explicar quando a IA aparece diante do usuário.
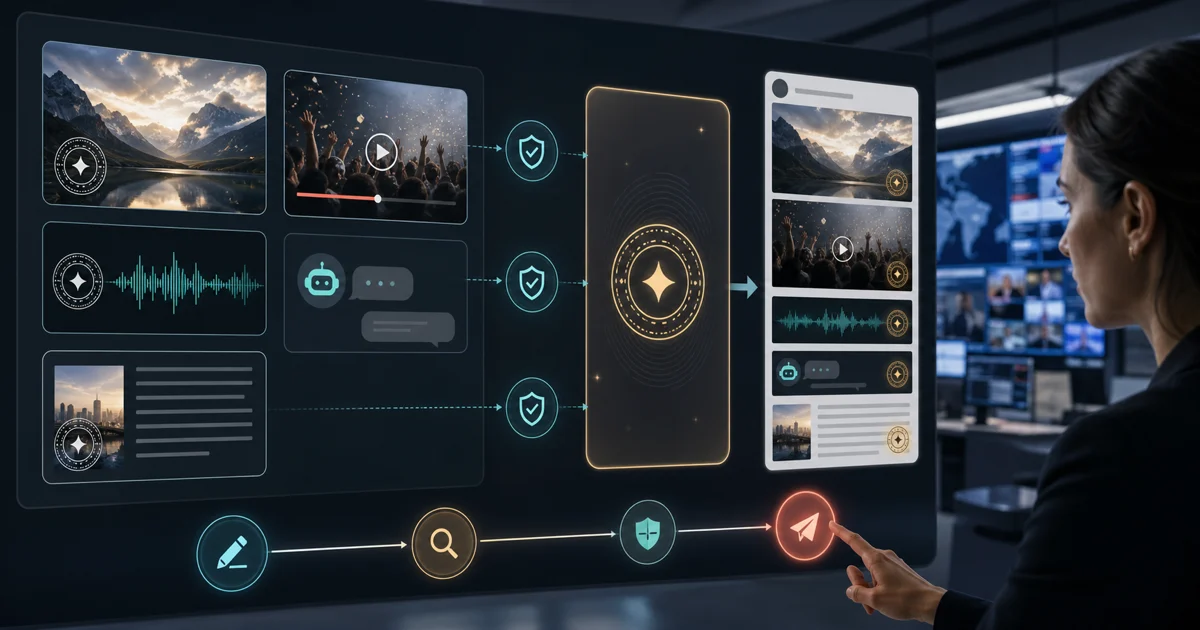 Capa editorial mostrando peças de conteúdo com IA passando por camadas de rótulo, procedência e revisão antes da publicação
TL;DR do dia
- A União Europeia colocou data na transparência: as obrigações do Artigo 50 do AI Act passam a valer em 2 de agosto de 2026 para interações com IA, deepfakes, conteúdo sintético e textos públicos sem revisão editorial.
- O código europeu virou caminho prático de compliance: cerca de 190 organizações já assinaram o Code of Practice on Transparency of AI-generated Content, que separa marcação técnica para provedores e rótulo visível para quem publica.
- OpenAI apoiou os códigos europeus: a empresa ligou segurança, transparência e procedência a práticas como Content Credentials, C2PA e SynthID, incluindo expansão para áudio.
- Google mostrou que watermark virou infraestrutura de distribuição: SynthID já foi usado em mais de 100 bilhões de imagens e vídeos e 60 mil anos de áudio, além de verificação em Search, Gemini e Chrome.
- A decisão prática: antes de publicar conteúdo com IA, defina onde o rótulo aparece, qual origem fica registrada, quem revisa e como o usuário entende que aquilo teve participação de IA.
Notícias selecionadas
1. A União Europeia colocou a placa de "feito com IA" na porta
A Comissão Europeia publicou as diretrizes finais para as obrigações de transparência do Artigo 50 do AI Act. A data é importante: as regras passam a ser aplicáveis em 2 de agosto de 2026.
O texto separa dois tipos de responsabilidade.
Provedores de sistemas de IA precisam desenhar o produto para que a pessoa saiba quando está interagindo diretamente com IA. Também precisam adicionar marcas legíveis por máquina para permitir detecção de conteúdo gerado ou manipulado.
Quem implanta ou publica com IA precisa informar quando o usuário está diante de deepfake, ferramenta de reconhecimento emocional, categorização biométrica ou texto sobre assunto de interesse público sem revisão humana ou controle editorial.
Para leigo: se a IA está falando com você ou se o conteúdo parece real, mas foi gerado ou alterado por IA, a regra caminha para uma ideia simples: a pessoa não deveria precisar adivinhar.
Por que isso importa: transparência deixou de ser texto escondido em termos de uso. Ela precisa aparecer no produto, no conteúdo e no momento em que o usuário forma confiança.
Isso muda a rotina de quem constrói produto, conteúdo e marketing. Um chatbot de atendimento precisa deixar claro quando é IA. Um texto automático sobre política, saúde, finanças ou notícia precisa de revisão editorial ou rótulo. Uma imagem realista de produto, pessoa, evento ou depoimento não pode circular como se fosse foto comum se isso induz o usuário a erro.
O ponto não é matar criação com IA. É impedir que o público confunda simulação com realidade.
2. O código europeu virou manual prático para provedores e publicadores
A página oficial do Code of Practice on Transparency of AI-generated Content mostra como essa regra sai do conceito e vira operação.
O código tem duas partes. A primeira trata de provedores: como marcar e detectar conteúdo gerado ou manipulado por IA. A segunda trata de deployers, ou seja, empresas e pessoas que colocam o sistema ou o conteúdo diante do público: como rotular deepfakes e textos gerados por IA em certos contextos.
O detalhe prático é que o código é voluntário, mas as obrigações legais não são. Quem assina ganha um caminho reconhecido para demonstrar conformidade. Quem não assina precisa provar por outros meios que suas medidas são adequadas.
A Comissão diz que, até o fim de julho de 2026, cerca de 190 empresas e organizações assinaram o código. Também criou um conjunto de ícones que podem ser usados para rotular conteúdo gerado por IA.
Para leigo: é como a diferença entre "vou seguir o manual aprovado" e "vou provar sozinho que meu jeito funciona".
Por que isso importa: para negócios menores, o sinal não é copiar a burocracia europeia inteira. É criar uma rotina mínima antes de escalar conteúdo sintético.
Uma PME, agência, creator ou founder pode começar com quatro perguntas:
- o usuário percebe que está falando com IA?
- a peça parece real ou pode enganar?
- há revisão humana antes de publicar assunto sensível?
- existe registro de ferramenta, prompt, ativo original e aprovação?
Se a resposta for "não sei", o risco não é só jurídico. É reputacional. O cliente pode descobrir tarde, se sentir enganado e questionar o resto da promessa.
3. OpenAI tratou procedência como parte de confiança, não como rodapé
A OpenAI publicou em 31 de julho o texto Advancing responsible AI across Europe. A empresa disse ter contribuído e endossado dois códigos europeus: o GPAI Code of Practice e o Code of Practice on Transparency of AI-Generated Content.
O trecho mais útil para quem constrói é a parte sobre procedência. A OpenAI descreve dois sistemas trabalhando juntos: Content Credentials, baseados no padrão C2PA, e SynthID, usado como watermark. A empresa também diz estar expandindo essa camada para áudio.
Para leigo: metadata é como a ficha técnica que viaja junto do arquivo. Watermark é como uma marca escondida dentro do conteúdo. Um ajuda a explicar o histórico; o outro tenta preservar um sinal mesmo quando a ficha técnica se perde.
Nenhum dos dois resolve tudo sozinho. Arquivo é baixado, comprimido, editado, reenviado, cortado, copiado, remixado e publicado em plataforma que talvez apague metadata. Por isso a decisão prática não é "coloque uma marca e esqueça". É criar uma cadeia simples de confiança.
Por que isso importa: quando imagem, vídeo e áudio sintético viram parte do produto, a origem precisa ser pensada antes da publicação, não depois da crise.
Esse ponto conversa com o post antigo sobre IA precisar provar origem, mas a pergunta de hoje é mais pública. Lá, o foco era rastro e auditoria. Aqui, o foco é o que aparece para quem consome: a pessoa sabe que há IA envolvida antes de confiar?
Para marketing, isso muda peças comuns:
- avatar em vídeo de venda;
- voz sintética em anúncio;
- imagem de produto montada por IA;
- depoimento reencenado;
- texto automático sobre tema sensível;
- chatbot que parece atendente humano;
- resumo de notícia publicado sem editor.
O usuário não precisa ver todo o log técnico. Mas precisa de contexto suficiente para calibrar confiança.
4. Google mostrou a escala do problema: origem precisa viajar pela web
O Google também assinou o EU AI Act Code of Practice on Transparency of AI-Generated Content. A empresa ligou essa assinatura a C2PA e SynthID, mas fez um alerta importante: rótulo demais, mal explicado ou sobreposto pode confundir as pessoas.
Esse é o ponto que builders e marketers precisam levar a sério. Transparência não é jogar um selo em tudo. É ajudar a pessoa a entender o que importa.
Em maio, o Google detalhou sua expansão de ferramentas para entender como conteúdo foi criado e editado. Segundo a empresa, SynthID já havia sido integrado a produtos generativos e usado para marcar mais de 100 bilhões de imagens e vídeos, além de 60 mil anos de áudio. A verificação também entrou em Gemini, Search e Chrome.
Para leigo: se a mídia viaja por muitos canais, a origem precisa viajar junto. Um rótulo que só funciona dentro de uma ferramenta não basta quando o arquivo sai dali e entra em WhatsApp, Instagram, site, anúncio, e-mail, apresentação ou notícia.
Por que isso importa: conteúdo com IA não vive em uma única plataforma. Ele circula. A empresa precisa pensar em origem como parte da distribuição.
Para uma agência, isso muda o briefing. Não basta pedir "faça 20 criativos com IA". O briefing bom inclui:
- quais ativos são reais;
- quais foram gerados;
- quais foram apenas editados;
- qual ferramenta foi usada;
- se há pessoa, voz, produto ou local real;
- qual rótulo o canal exige;
- quem aprovou;
- onde fica a versão final.
Isso parece detalhe operacional, mas evita uma bagunça comum: ninguém saber depois se aquela imagem era foto real, mockup, render, edição ou peça sintética.
5. Watermark ajuda, mas não substitui revisão e registro
Um paper submetido ao arXiv em 17 de julho, AI Watermark Evidence Fails Forensic Readiness, traz o lado incômodo da conversa. Os autores testaram métodos de watermark em texto e encontraram fragilidades sérias quando o conteúdo passa por paráfrase.
O ponto não é jogar fora watermark. O ponto é entender limite.
Para leigo: uma etiqueta ajuda, mas não transforma qualquer arquivo em prova perfeita. Se alguém corta, reescreve, comprime, copia, printa ou passa por outra ferramenta, o sinal pode enfraquecer.
Por isso a estratégia mais madura combina camadas:
- rótulo visível para o usuário;
- registro interno de origem;
- metadata ou Content Credentials quando possível;
- watermark quando a ferramenta oferece;
- revisão humana antes de assunto sensível;
- política clara para o canal;
- arquivo final aprovado e guardado.
Por que isso importa: se você depende de uma única tecnologia para provar origem, pode descobrir tarde que ela não aguenta o fluxo real de publicação.
O produto bom não promete "detecção perfeita de IA". Ele explica o nível de confiança e deixa um caminho de revisão. Para PMEs, isso é mais simples do que parece: guarde a fonte do ativo, salve o prompt ou briefing quando for relevante, registre aprovação e seja claro com o usuário quando a IA muda a percepção de realidade.
O padrão que apareceu hoje
O padrão das notícias de IA hoje é que conteúdo com IA deixou de ser invisível.
A União Europeia colocou data e escopo nas obrigações de transparência. O código europeu ofereceu um manual para provedores e publicadores. OpenAI conectou procedência a C2PA, Content Credentials e SynthID. Google mostrou que watermark e verificação precisam operar em escala de web. A pesquisa sobre watermark lembrou que nenhuma camada técnica resolve sozinha.
O fio comum é simples:
- gerar ficou barato;
- parecer real ficou fácil;
- distribuir ficou instantâneo;
- enganar também ficou mais barato;
- confiar ficou mais difícil;
- rótulo, origem e revisão viraram parte da experiência.
Essa leitura corta uma ilusão comum: achar que transparência é só assunto jurídico.
Não é.
Transparência é produto. É UX. É copy. É processo editorial. É política de anúncio. É rotina de agência. É confiança de cliente. É a diferença entre "usei IA para trabalhar melhor" e "fingi que a IA não existia para convencer você".
Quem acompanha /noticias vai continuar vendo modelos, agentes e ferramentas novas. O filtro de hoje é outro: quando a IA aparece para o público, a pessoa entende o suficiente para confiar com critério?
O que isso muda pra quem constrói
1. Desenhe o rótulo antes da campanha. Se a peça usa avatar, voz, imagem realista, texto público ou chatbot, decida onde o aviso aparece antes de rodar mídia ou publicar.
2. Separe "feito por IA" de "assistido por IA". Revisar gramática com IA não é igual a inventar uma pessoa falando. Editar luz não é igual a criar um depoimento. A diferença precisa aparecer na política interna.
3. Guarde origem como parte do arquivo final. Ferramenta, prompt, ativo inicial, licença, editor humano, data e canal de publicação devem ficar registrados quando a peça for pública ou sensível.
4. Não confie só no detector. Detector e watermark ajudam, mas podem falhar. Use também revisão, aprovação, versionamento e bom senso editorial.
5. Explique em linguagem humana. "Conteúdo sintético multimodal com procedência C2PA" pode estar certo tecnicamente, mas não ajuda o cliente comum. Melhor: "imagem criada com IA e revisada pela equipe".
6. Faça transparência virar confiança, não medo. Avisar que houve IA pode aumentar credibilidade quando a empresa mostra que houve revisão humana, autorização e responsabilidade.
Para builders, founders, marketers, criadores, PMEs e profissionais que usam IA para produto, automação e negócio, a decisão prática é esta: crie uma regra de publicação com IA antes de escalar conteúdo: quando rotular, onde registrar origem, quem revisa e o que o usuário precisa saber.
E o Brasil nessa história?
No Brasil, essa virada vai aparecer primeiro onde a IA já está sendo usada sem muita cerimônia: WhatsApp, Instagram, VSL, tráfego pago, avatar, locução, post de social, landing page, atendimento, curso online, notícia local e conteúdo de saúde, finanças ou política.
Muita PME brasileira não vai começar lendo o AI Act europeu. Mas vai sentir a mudança por meio das plataformas.
O canal pode pedir rótulo. O anúncio pode exigir disclosure. O cliente pode perguntar se o depoimento é real. Uma marca parceira pode pedir prova de licença. Um vídeo pode ser denunciado. Um chatbot pode ser questionado por se passar por humano. Uma peça pode viralizar pelo motivo errado.
A rotina prática pode ser simples:
- todo conteúdo com IA tem responsável;
- toda peça pública tem status: humana, assistida por IA ou gerada por IA;
- todo uso de voz, rosto, pessoa, depoimento ou produto real exige aprovação;
- todo assunto sensível precisa de revisão humana;
- todo anúncio com IA guarda origem e versão aprovada;
- todo chatbot se identifica quando a conversa pode parecer humana.
Isso não é burocracia de empresa grande. É higiene de publicação.
Para quem vende serviço de IA no Brasil, a oportunidade melhor não é prometer "faço conteúdo infinito". É vender uma máquina de conteúdo que aguenta pergunta difícil: de onde veio, quem revisou, qual parte é IA, onde está o rótulo e quem responde se der problema.
Se você quer transformar esse tipo de leitura em produto, automação, marketing ou rotina editorial com método, o caminho mais direto é entrar no /pro. E para acompanhar as próximas viradas práticas do mercado, veja a curadoria em /noticias.
A pergunta final de hoje é:
qual conteúdo do seu negócio parece humano, mas já tem IA suficiente para merecer rótulo, origem e revisão?
Comece por esse conteúdo. A IA não precisa desaparecer. Ela precisa se apresentar direito.