Pesquisadores do KAIST desenvolvem IA de leitura labial com recorde em teste
O DLLM-VSR identifica palavras pelos movimentos dos lábios em vídeos sem áudio e teve o melhor resultado entre métodos treinados com os mesmos dados. O sistema ainda está em desenvolvimento.
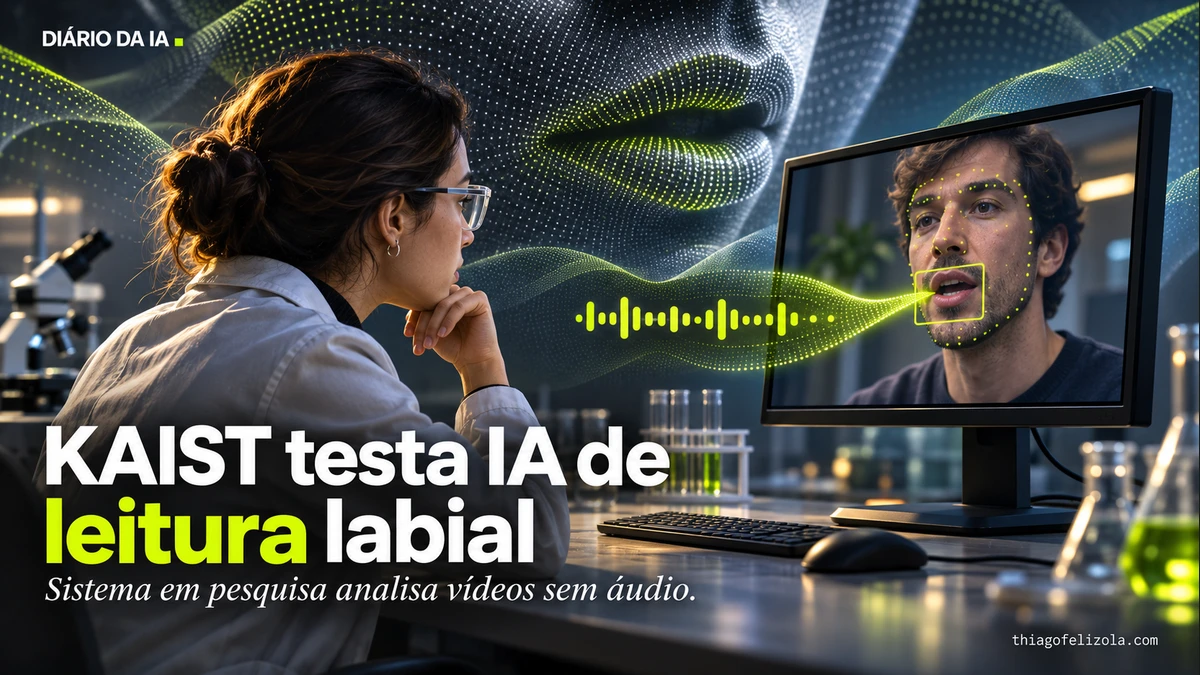
Pesquisadores do Instituto Avançado de Ciência e Tecnologia da Coreia (KAIST) desenvolveram o DLLM-VSR, uma IA que identifica palavras pelos movimentos dos lábios em vídeos sem áudio. Em testes no benchmark LRS3, o sistema registrou taxa de erro de palavras de 19,4%, o melhor resultado entre métodos treinados com o mesmo conjunto de dados. O treinamento usou 433 horas de vídeos rotulados.
A ferramenta usa um modelo de linguagem baseado em difusão. Em vez de interpretar a fala apenas da esquerda para a direita, identifica primeiro as palavras em que tem mais confiança e usa informações das partes anteriores e posteriores da frase para preencher lacunas. Também gera transcrições para diferentes comprimentos possíveis da frase, conforme a duração do vídeo, e seleciona a mais plausível.
A taxa de erro contabiliza palavras reconhecidas incorretamente, omitidas ou acrescentadas. Não representa a porcentagem de conversas completas compreendidas corretamente, e o desempenho varia conforme os dados usados. O sistema ainda precisa de ajustes para reduzir o processamento e funcionar em tempo real, sem internet, em robôs e dispositivos vestíveis. A capacidade de interpretar vídeos sem áudio também levanta questões de privacidade.
O que muda para você
Por enquanto, o DLLM-VSR não está disponível ao público nem no mercado. A pesquisa pode interessar a quem trabalha com acessibilidade ou comunicação em ambientes ruidosos, mas ainda não oferece um recurso pronto para uso. Segundo a fonte, faltam ajustes para reduzir o processamento e permitir operação em tempo real, sem internet, nos robôs e dispositivos vestíveis citados.
Minha leitura
A comparação é forte dentro de um limite claro: o sistema superou métodos treinados com os mesmos dados, mas isso não prova que entenda conversas inteiras com a mesma precisão. Para virar recurso de acessibilidade, precisa funcionar em tempo real e lidar com vídeos diferentes dos usados nos testes. E a possibilidade de deduzir falas a partir de imagens sem áudio torna a privacidade parte central do debate, não um detalhe técnico.
 Thiago FelizolaConsultor de IA, curador do Diário da IA