NVIDIA e Princeton detalham ReplaySSM para acelerar modelos híbridos
A NVIDIA e o Dao AI Lab de Princeton publicaram um trabalho sobre uma técnica que reduz gravações do estado de modelos híbridos. Nos testes, os ganhos apareceram em lotes grandes, não no lote unitário.
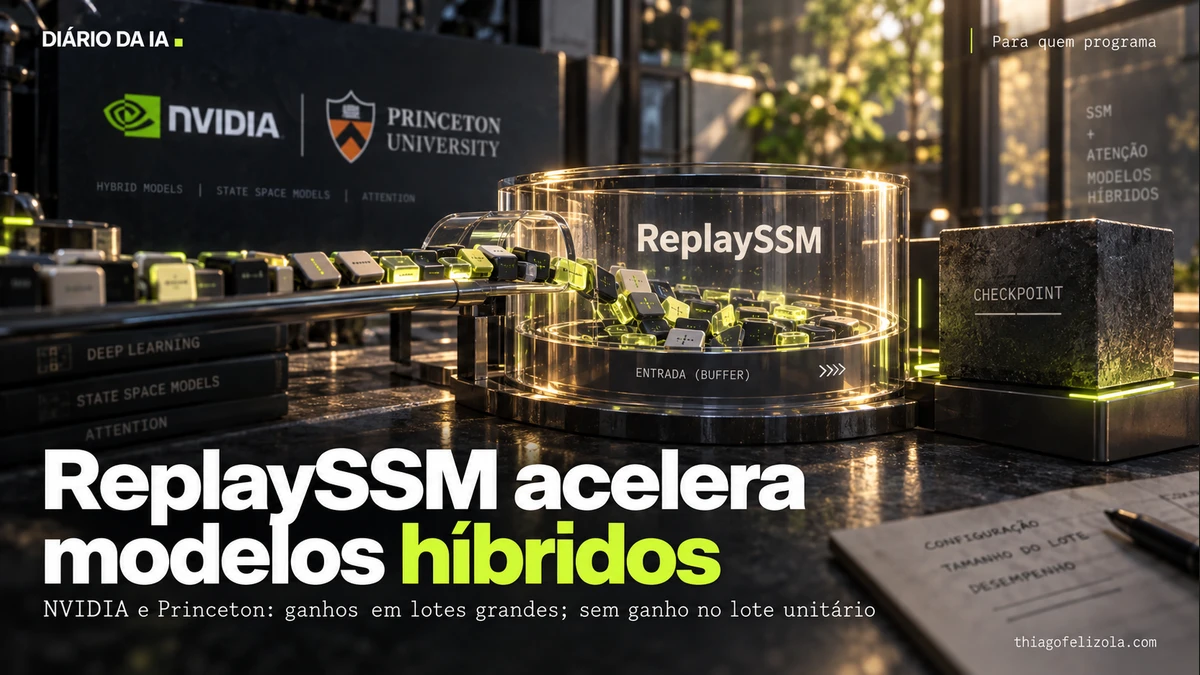
A NVIDIA e o Dao AI Lab da Universidade de Princeton publicaram no arXiv um trabalho sobre o ReplaySSM, técnica para decodificar modelos híbridos que combinam camadas de espaço de estado (SSM) e atenção. O código está no GitHub, e a técnica foi integrada ao TensorRT-LLM, vLLM, SGLang e FlashInfer, segundo os autores.
O ReplaySSM representa o estado do modelo como um ponto de controle e um buffer de entradas recentes. Com isso, calcula a saída a cada etapa, mas grava o estado completo apenas quando o buffer se enche. Em testes com quatro modelos, a camada SSM foi de 1,46 a 1,80 vez mais rápida com lote de 256; a etapa de decodificação inteira acelerou de 1,20 a 1,47 vez. Com lote unitário, não houve ganho.
A técnica também permite descartar tokens provisórios da decodificação especulativa sem salvar cópias do estado para cada um. Em testes com lote de 512 e quatro tokens candidatos, o ritmo de processamento foi 1,85 e 2,10 vezes o do modo especulativo do vLLM nos dois modelos de classe 120 bilhões, com comprimentos de aceitação equivalentes. Para baixa precisão, a separação entre leituras e atualizações reduz a propagação de erros de arredondamento. Os autores também relatam resultados de precisão em avaliações, que variam conforme o modelo e o formato usado.
O que muda para você
A técnica interessa a equipes que operam modelos híbridos em sistemas de inferência. Ela já foi integrada a ferramentas como vLLM e TensorRT-LLM e é usada em produção no GLM-5.3-Flash e no Kimi-K3, segundo o artigo. Os ganhos medidos dependem de lotes grandes; no lote unitário testado, não houve aceleração. Para quem usa apenas um chatbot, a fonte não aponta mudança imediata.
Minha leitura
O ReplaySSM chama atenção pelo limite dos próprios resultados: os ganhos apareceram com muitos pedidos processados em lote, não com um pedido isolado. Isso torna a técnica relevante para quem opera serviços de IA, mas não permite prometer respostas mais rápidas para todo usuário. Eu compararia os números com o padrão de uso real do sistema: uma melhoria em lote só vale se a operação conseguir aproveitar esse tipo de processamento.
 Thiago FelizolaConsultor de IA, curador do Diário da IA