NVIDIA e AI4Bharat preparam corpus de 2,8 trilhões de tokens em línguas indianas
A NVIDIA e a AI4Bharat detalharam um conjunto de dados e uma receita aberta para gerá-los, com divulgação prevista para breve. O corpus abrange 22 línguas e inclui versões romanizadas de 12 delas.
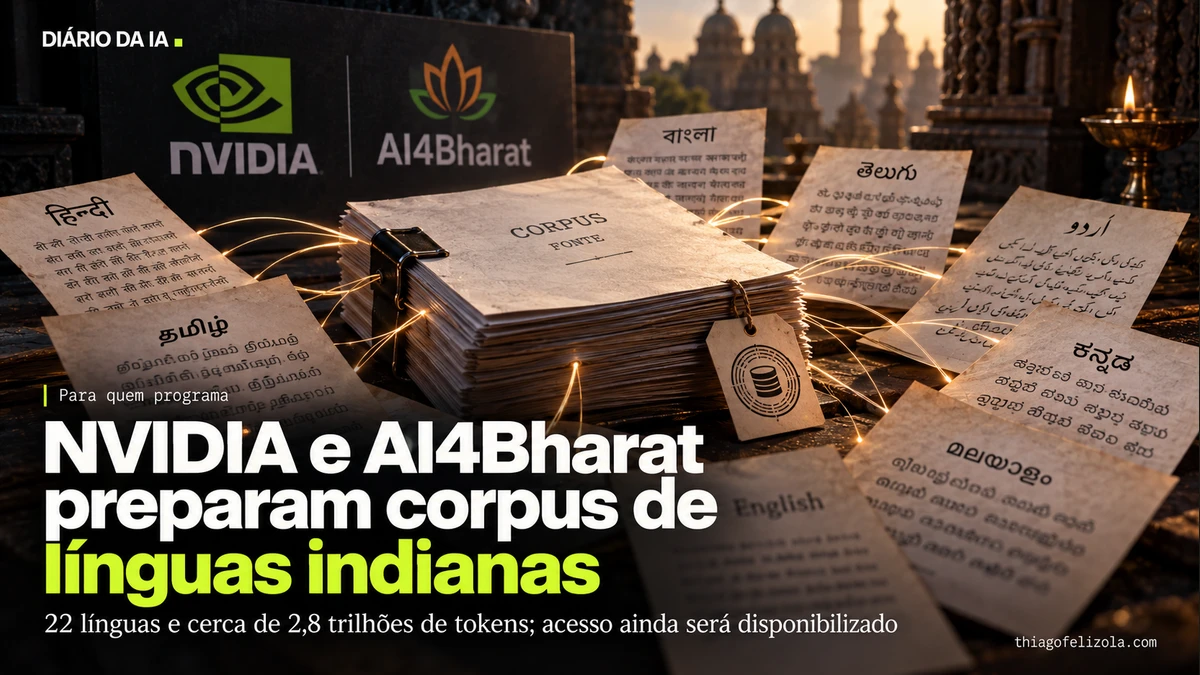
A NVIDIA e a AI4Bharat, laboratório de pesquisa do IIT Madras, detalharam um corpus de aproximadamente 2,8 trilhões de tokens em 22 línguas indianas e o processo aberto usado para criá-lo. A publicação diz que ambos serão disponibilizados em breve, sem informar uma data.
O conjunto parte de documentos em inglês sobre temas como matemática, programação e perguntas e respostas, traduzidos para as línguas indianas. Segundo a publicação, são 2.601,0 bilhões de tokens em escrita nativa e 224,6 bilhões em texto romanizado, que usa o alfabeto latino. Doze línguas aparecem nas duas formas; as outras dez, apenas na escrita nativa. As contagens usam o tokenizador Gemma-4 e incluem traduções e variantes de escrita de fontes compartilhadas, não documentos únicos.
A receita descreve tradução, avaliação de qualidade e correção de textos, com cada registro ligado ao documento de origem. Em parte do processo, a equipe reteve traduções com nota mínima de 75 em 100; a nota é uma avaliação por critérios de qualidade, não uma porcentagem de acerto. A publicação ressalva que os dados sintéticos complementam textos produzidos naturalmente, importantes para conhecimento e contexto cultural locais.
Em uma etapa de treinamento continuado do Nemotron 3.5 Super VL, as pontuações subiram em cinco avaliações de conhecimento e raciocínio em línguas indianas. A comparação combina dados sintéticos e naturais, portanto não isola a contribuição deste corpus. A avaliação do conjunto completo ainda é um estudo futuro.
O que muda para você
Para quem não desenvolve modelos, nada muda de imediato: os dados e a receita ainda serão disponibilizados. Equipes de pesquisa e desenvolvimento poderão usar o corpus ou adaptar o processo a documentos próprios. A publicação não informa data de acesso nem condições de licença; recomenda consultar o cartão do conjunto de dados e a licença antes de treinar modelos.
Minha leitura
O valor prático está em abrir também o processo de geração, não só o conjunto de dados. Isso permite que equipes examinem a origem dos textos e adaptem o método. Mas o volume, por si só, não garante um modelo melhor: os resultados divulgados misturam dados sintéticos e naturais, e a avaliação do corpus completo ainda está por fazer. Para decidir se serve, eu começaria pela cobertura das línguas e escritas necessárias e pela qualidade de uma amostra.
 Thiago FelizolaConsultor de IA, curador do Diário da IA