Microsoft transforma checagens de banco de dados em recompensas para treinar agentes
A Microsoft apresentou no Hugging Face o ThinkingBox-Training, disponível no GitHub, para usar o resultado final de tarefas como sinal de treinamento. Em teste, o Qwen3.8-27B repetiu o sucesso em mais tarefas, mas teve uma pequena queda na cobertura.
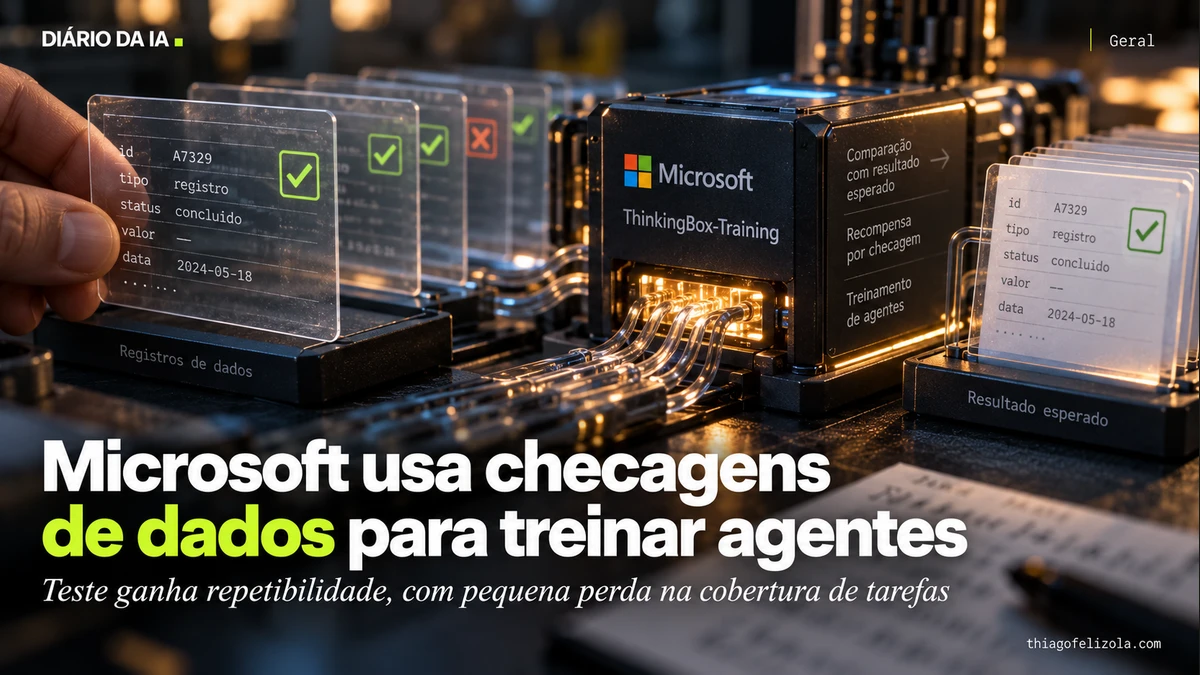
A Microsoft publicou um método de pós-treinamento que usa checagens do estado final de bancos de dados como recompensas para agentes. O ThinkingBox-Training está disponível no GitHub, segundo a publicação no Hugging Face. A proposta parte do ThinkingBox, que verifica se os registros finais correspondem ao resultado esperado, em vez de avaliar apenas as ações do agente.
A equipe treinou o Qwen3.8-27B por 50 etapas com GRPO, uma técnica de pós-treinamento. No ThinkingBox-Bench, com 507 tarefas e 20 tentativas por tarefa, a taxa média de sucesso subiu de 51,70% para 60,78%. O número de tarefas aprovadas em todas as tentativas passou de 38 para 107.
As tarefas do benchmark ficaram fora do treinamento. Segundo a Microsoft, domínios, bancos de dados e a maioria das ferramentas eram diferentes, mas os conjuntos ainda compartilhavam o formato ThinkingBox, a avaliação pelo estado final e alguns elementos de execução. A equipe também registrou uma pequena queda na proporção de tarefas resolvidas ao menos uma vez: o ganho foi de repetibilidade, não de cobertura mais ampla.
A estimativa de custo por tentativa bem-sucedida caiu de US$ 0,177 para US$ 0,139. A conta considera o custo de inferência, mas exclui o treinamento e a seleção das tarefas; a Microsoft ressalva que esses valores são um índice comparativo, não uma fatura de serviço em nuvem.
O que muda para você
O método interessa a equipes que treinam agentes para executar tarefas em sistemas com bancos de dados. O código está disponível no GitHub, mas a publicação não apresenta isso como um recurso pronto para usuários finais. Os resultados vêm de uma avaliação específica do Qwen3.8-27B: mostram mais consistência nas tarefas testadas, com uma pequena perda de cobertura, e não garantem o mesmo resultado em outros sistemas.
Minha leitura
Para agentes que alteram registros, repetir um acerto pode valer mais do que acertar uma vez em mais tarefas. A Microsoft mediu essa diferença, mas o teste ainda compartilha elementos com o treinamento, então a transferência tem limites. Eu não trataria o ganho de consistência como prova de confiabilidade em produção. O critério é observar, no sistema real, tanto quantas tarefas o agente resolve quanto quantas ele repete sem falhar.
 Thiago FelizolaConsultor de IA, curador do Diário da IA