IBM apresenta prévias do LLMON para modelos Granite 4.1
A IBM disponibilizou duas versões experimentais, de 3B e 8B parâmetros, treinadas para usar uma marcação que explicita a estrutura do contexto. Em testes divulgados pela empresa, elas resistiram melhor a ataques indiretos de prompt injection.
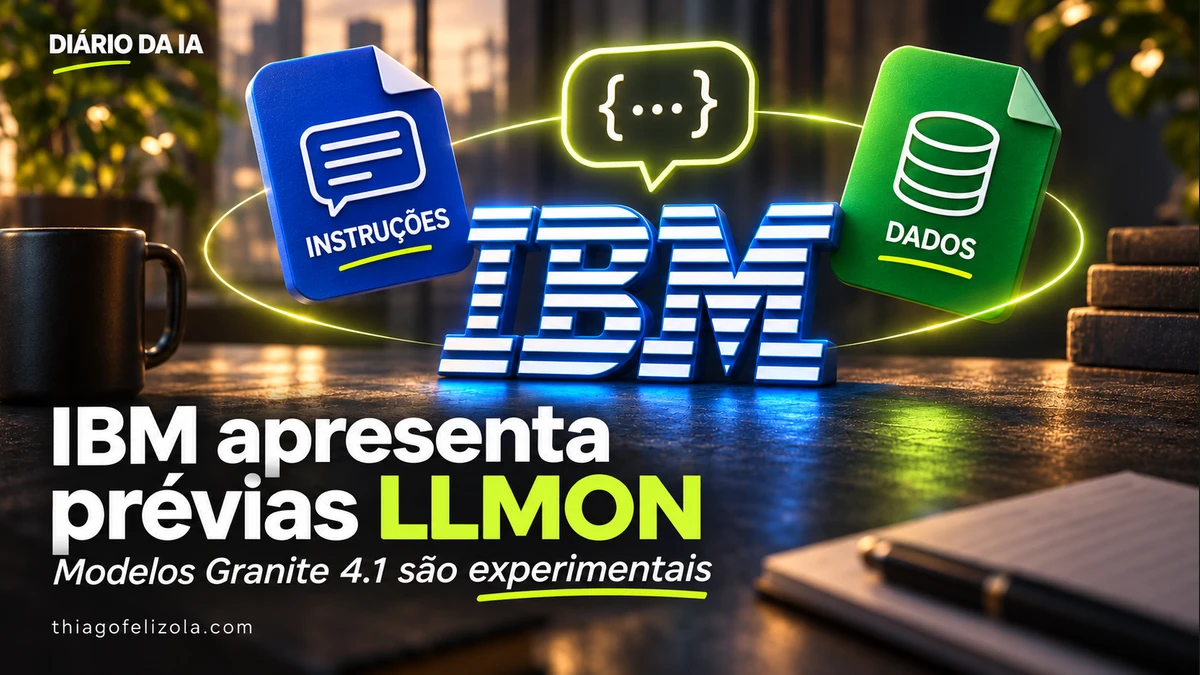
A IBM disponibilizou duas prévias experimentais do LLMON, uma linguagem de marcação criada para explicitar a estrutura e o significado das partes do contexto de um modelo. Os modelos granite-4.1-3b-LLMON-preview e granite-4.1-8b-LLMON-preview derivam dos modelos base Granite 4.1 e foram treinados para ler e gerar textos com essa marcação. A empresa também publicou um repositório no GitHub com ferramentas e exemplos de uso.
O LLMON usa delimitadores especiais para separar blocos, como instruções, dados e requisitos, e vincular instruções aos dados sobre os quais devem agir. A IBM criou conversores que traduzem JSON para LLMON e de volta sem perda de informação. A marcação complementa os modelos de conversa; não os substitui.
No benchmark OPI, que avalia ataques indiretos inseridos em dados, a IBM afirma que as prévias evitaram 47% mais ataques do que o melhor modelo de fronteira testado e 95% mais do que o melhor modelo de código aberto. A empresa ressalva que o teste mede ataques estáticos e que ainda trabalha em ataques adaptativos, desenvolvidos ao longo de várias interações. Nos benchmarks gerais, os modelos tiveram desempenho semelhante ao Granite 4.1 Instruct. A IBM diz que as prévias estão disponíveis para exploração e avaliação, mas não para produção.
O que muda para você
As prévias servem a quem já experimenta com Granite 4.1 de 3B ou 8B parâmetros. Segundo a IBM, é possível substituí-los pelas versões LLMON sem criar um fluxo de conversão; o modelo inclui um formato de conversa que organiza as partes do contexto. Para quem não desenvolve ou avalia modelos, nada muda de imediato. As versões ainda não são indicadas para produção.
Minha leitura
A IBM está testando uma forma de ensinar o modelo a distinguir instruções de conteúdo que ele só deve analisar. Isso pode ajudar contra ataques indiretos, mas o resultado divulgado vale para os testes descritos pela empresa, não para qualquer cenário. E a própria IBM diz que essa separação é um comportamento aprendido, não uma garantia imposta tecnicamente. Eu usaria essas prévias para avaliar a abordagem, não como proteção pronta para produção.
 Thiago FelizolaConsultor de IA, curador do Diário da IA