AWS detalha habilidade para avaliar e configurar cache em LLMs hospedados em GPUs
A AWS mostrou como uma habilidade do Agent Toolkit for AWS ajuda agentes de programação a avaliar e configurar cache KV distribuído com Amazon ElastiCache. A empresa afirma que a técnica pode reduzir custos de inferência em até 40% e o tempo até o primeiro token em até 80%.
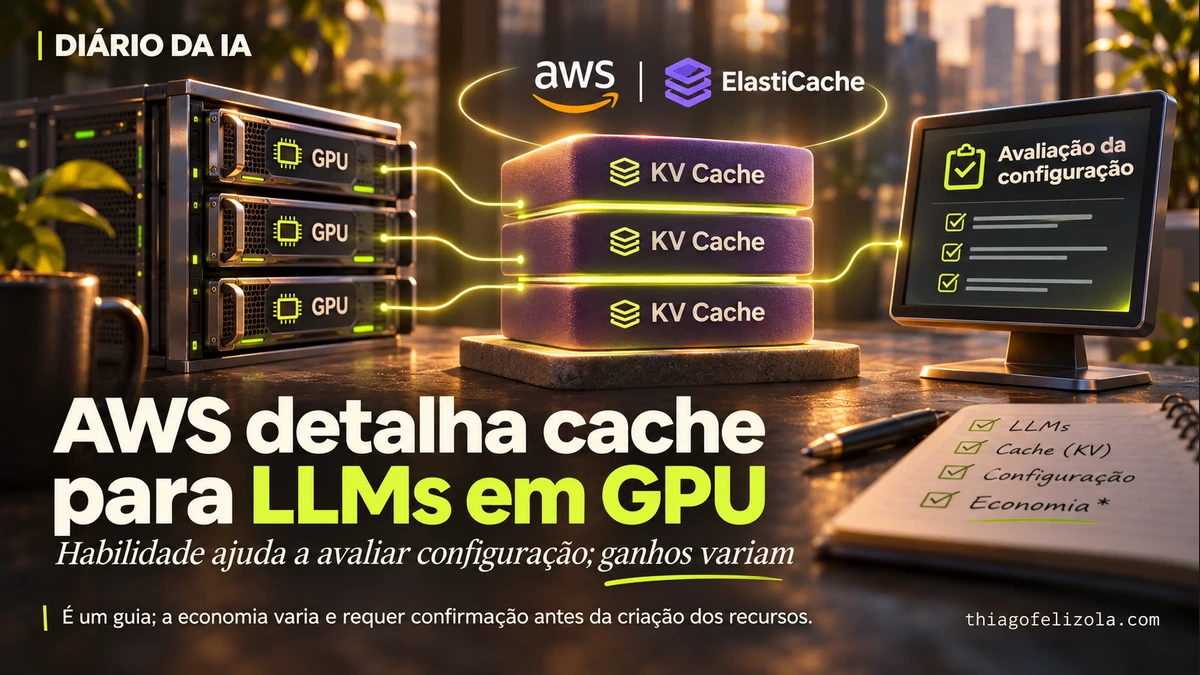
A AWS publicou um guia sobre uma habilidade do Agent Toolkit for AWS que ajuda agentes de programação a avaliar e configurar cache KV distribuído para modelos de linguagem hospedados em GPUs. Ela funciona com Kiro, Claude Code, OpenAI Codex e outros agentes compatíveis com Agent Skills. O texto não anuncia o lançamento de um novo produto.
O cache compartilhado com Amazon ElastiCache permite que servidores reutilizem estados de atenção já calculados para conversas anteriores. Segundo a AWS, a técnica pode reduzir custos de inferência em até 40% e o tempo até o primeiro token em até 80%. Os benefícios variam conforme o modelo, o padrão de tráfego e o roteamento das solicitações.
A habilidade verifica se o cache pode ajudar, estima capacidade e preço e orienta a configuração. Antes de criar recursos, pede confirmação. A AWS recomenda usar o KVTrace para estimar os ganhos com registros de uso; a ferramenta não armazena o texto dos prompts nem os identificadores dos tokens. O tempo de GPU liberado só vira economia financeira se a operação reduzir o número de servidores ou atender mais tráfego com a mesma frota.
O que muda para você
A habilidade é voltada a equipes que hospedam modelos em GPUs e usam agentes de programação compatíveis com Agent Skills. Ela pode ajudar a avaliar o cache e orientar testes ou configuração com Amazon ElastiCache. A criação de recursos exige confirmação e tem um preço estimado. A economia não é garantida: depende do uso e da taxa de acertos do cache.
Minha leitura
A medição antes da configuração é a parte mais útil do guia. O ganho depende de quantas solicitações conseguem reaproveitar contexto, então o percentual máximo não diz quanto uma equipe específica vai economizar. E liberar tempo de GPU não reduz a conta por si só: é preciso usar menos servidores ou atender mais tráfego com a mesma frota. A decisão começa pelos dados da operação.
 Thiago FelizolaConsultor de IA, curador do Diário da IA