ArisGlobal reduz em cerca de 40% o gasto mensal de inferência com cache no Amazon Bedrock
A ArisGlobal reorganizou as solicitações do NavaX para reutilizar instruções compartilhadas entre casos e clientes. Segundo métricas de produção da empresa, a mudança também permitiu atender cerca de 15% mais clientes corporativos sem aumento proporcional de custos.
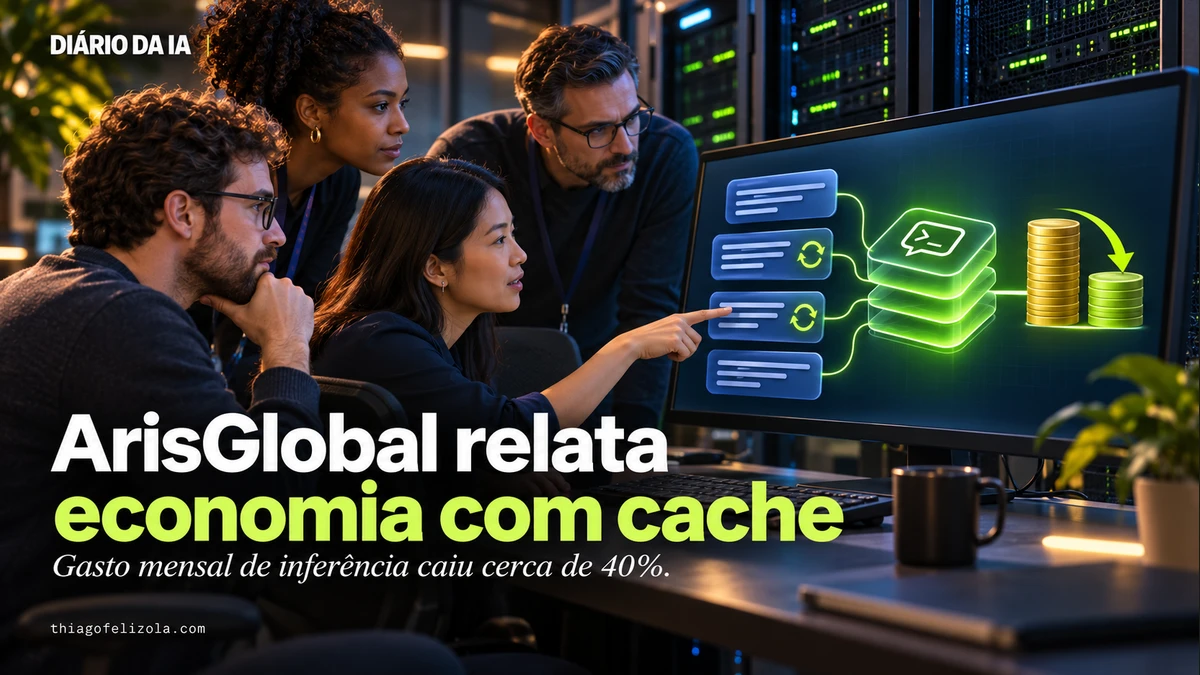
A ArisGlobal reorganizou as solicitações do NavaX, seu mecanismo de IA para processar casos de segurança de medicamentos, para aproveitar o cache de prompts do Amazon Bedrock. Em vez de armazenar documentos específicos de cada caso, passou a armazenar o prefixo compartilhado de instruções, regras e exemplos, que se repete entre solicitações e clientes.
A mudança respondeu ao crescimento desse prefixo, que passou de aproximadamente 72 mil para 180 mil tokens em seis meses. No mesmo período, o custo de inferência por caso subiu mais de 200%. Na configuração anterior, o documento podia ser reutilizado apenas nas solicitações do mesmo caso; as instruções compartilhadas continuavam sendo processadas integralmente a cada chamada.
Segundo métricas de produção da ArisGlobal, 65% dos tokens de entrada de uma solicitação típica passaram a ser atendidos pelo cache. Com mais de 19 bilhões de tokens por mês, a empresa registrou redução de aproximadamente 50% no custo efetivo de entrada e de cerca de 40% no gasto mensal total de inferência. Também relatou atender cerca de 15% mais clientes corporativos sem aumento proporcional de custos. Os resultados podem variar conforme a estrutura dos prompts, o tráfego e a taxa de acerto do cache.
O que muda para você
A mudança interessa a empresas que usam modelos pelo Amazon Bedrock em processos com instruções repetidas e documentos diferentes a cada caso. A ArisGlobal mostra que reorganizar o conteúdo enviado pode reduzir custos, mas os resultados divulgados são da operação da própria empresa e não garantem o mesmo efeito em outros sistemas. Para quem não administra esse tipo de aplicação, nada muda de imediato no uso cotidiano.
Minha leitura
O ganho veio de identificar o que se repete entre clientes, não de guardar o maior conteúdo possível. Isso importa para equipes que pagam por chamadas de modelo: um documento longo pode parecer o melhor candidato ao cache, mas, se muda a cada caso, tem menos chance de ser reaproveitado. Os resultados da ArisGlobal dependem da sua operação. Antes de aplicar a estratégia, eu mediria quanto do prompt permanece igual entre solicitações.
 Thiago FelizolaConsultor de IA, curador do Diário da IA