Ai2 apresenta o StateBench para avaliar mudanças de estado em documentos longos
A organização criou um benchmark para comparar como modelos acompanham informações que mudam ao longo de sequências extensas. Nos testes, modelos de fronteira tiveram queda acentuada nas tarefas mais difíceis.
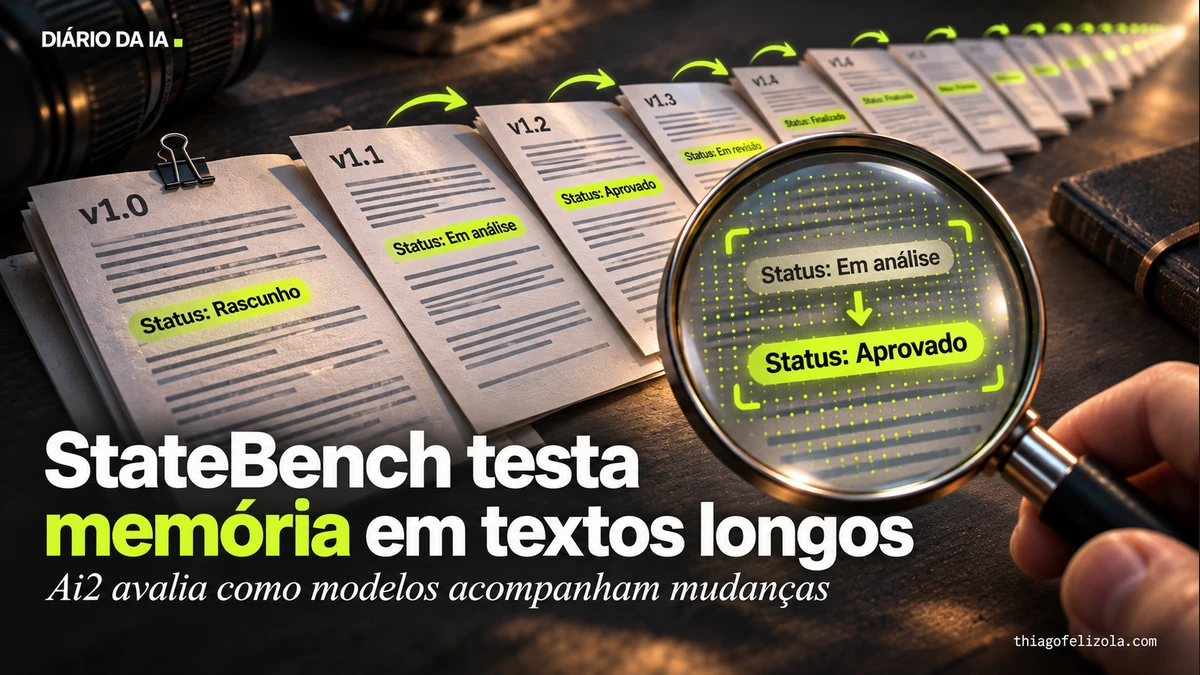
A Ai2 apresentou o StateBench, um benchmark para medir como modelos de linguagem acompanham mudanças nas informações sobre entidades ao longo de documentos extensos. O teste divide as tarefas em quatro níveis, desde localizar a atualização mais recente até seguir cadeias de mudanças em que uma etapa perdida pode levar a uma resposta errada.
A equipe avaliou modelos abertos pré-treinados, entre eles o Olmo 3, um transformer, e o Olmo Hybrid, que combina camadas Gated DeltaNet. Os modelos não haviam sido treinados com contextos acima de 64 mil tokens, e a maioria foi testada com entradas maiores. O desempenho caiu à medida que as tarefas ficaram mais complexas. O formato também fez diferença: alguns modelos tiveram resultados altos numa apresentação e ficaram perto do acaso quando a mesma tarefa foi apresentada como edição de planilha.
A Ai2 também testou Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna. Nos problemas mais difíceis, a precisão caiu conforme as entradas cresceram, chegando a 13% ou menos nas sequências mais longas do nível geral finito.
Em um experimento separado, modelos treinados diretamente no benchmark foram testados com sequências de até 64 mil atribuições, embora o treinamento chegasse a 256. Modelos recorrentes e híbridos generalizaram melhor nos níveis mais simples; transformers não aprenderam o nível mais difícil. O teste mantém fixo o número de variáveis e não cobre o surgimento de novas entidades ao longo do texto.
O que muda para você
O benchmark serve principalmente a pesquisadores que comparam arquiteturas e métodos de treinamento. Ele permite testar diferentes tipos de acompanhamento de mudanças, mas não é uma ferramenta para usuários finais nem demonstra que um modelo vai acompanhar melhor qualquer conversa ou documento. A Ai2 ressalta que o teste ainda não cobre situações em que novas pessoas ou objetos aparecem ao longo do texto.
Minha leitura
Separar os tipos de falha é mais útil do que tratar “acompanhar contexto” como uma capacidade única. Um modelo pode acertar atualizações simples e se perder quando várias mudanças dependem umas das outras. Ainda assim, o StateBench não mede tudo que acontece em documentos reais: mantém fixo o número de entidades. Eu usaria esses resultados para entender limites específicos, não para montar um ranking geral de modelos.
 Thiago FelizolaConsultor de IA, curador do Diário da IA